你问 AI 一个问题,它一个字一个字往外蹦。这些字是从哪儿来的?
不是翻问答本,也不是搜网页。
模型内部,每个字都是从三万两千个候选里挑出来的。
凭什么这么挑?这篇博客只回答这个问题。
证据是一个在你自己的笔记本上就能跑起来的语言模型:llama2.zig,1420 万个参数,不用显卡,整个实现是一个文件。
文中的每个数字都来自本机实测,不是编的。读完你可以跟任何人讲清楚「AI 是怎么生成文字的」。
虽然这只是个非常小的教学模型,但是核心的推理过程和当前的旗舰模型推理骨架完全相同。
没有旗舰模型换掉这个循环骨架。“超越 next-token prediction” 的研究(Meta 的 Large Concept Model、文本扩散模型)都还在实验室阶段,没人拿它当旗舰上线。
先看全貌:一个字的一生
模型不认识字母,也不认识汉字。它只认识整数。所以你的一句话要过四道关口:
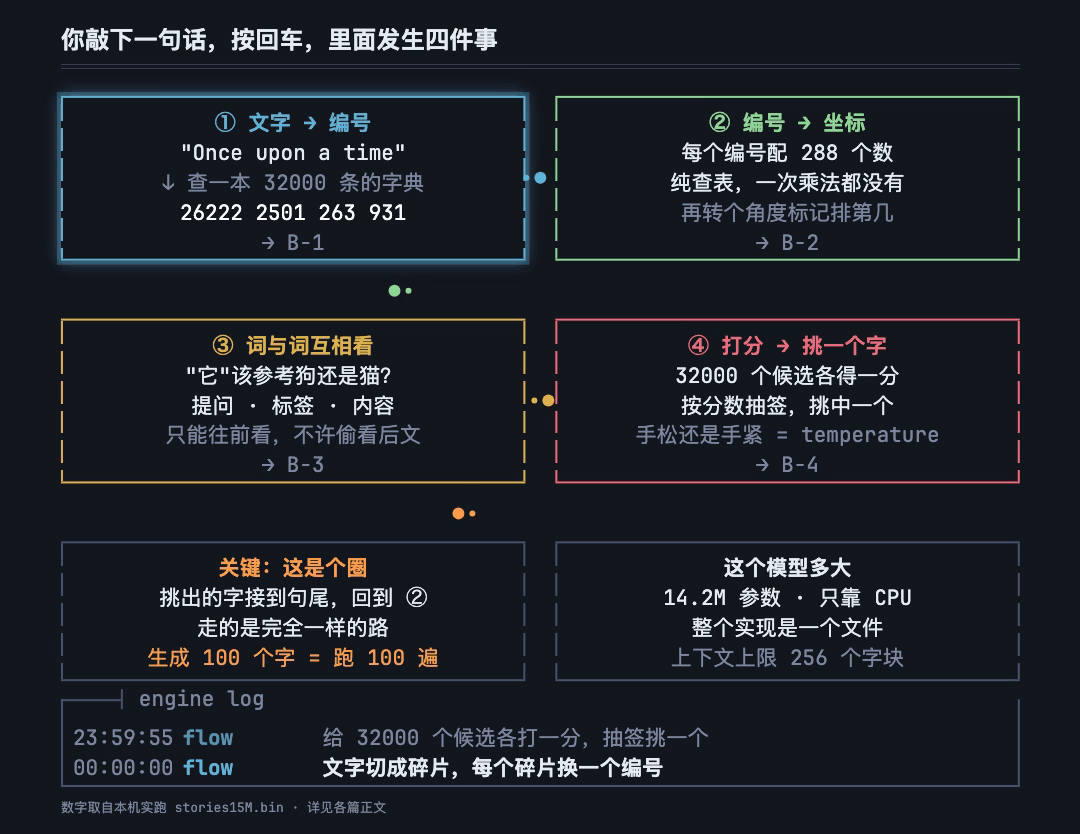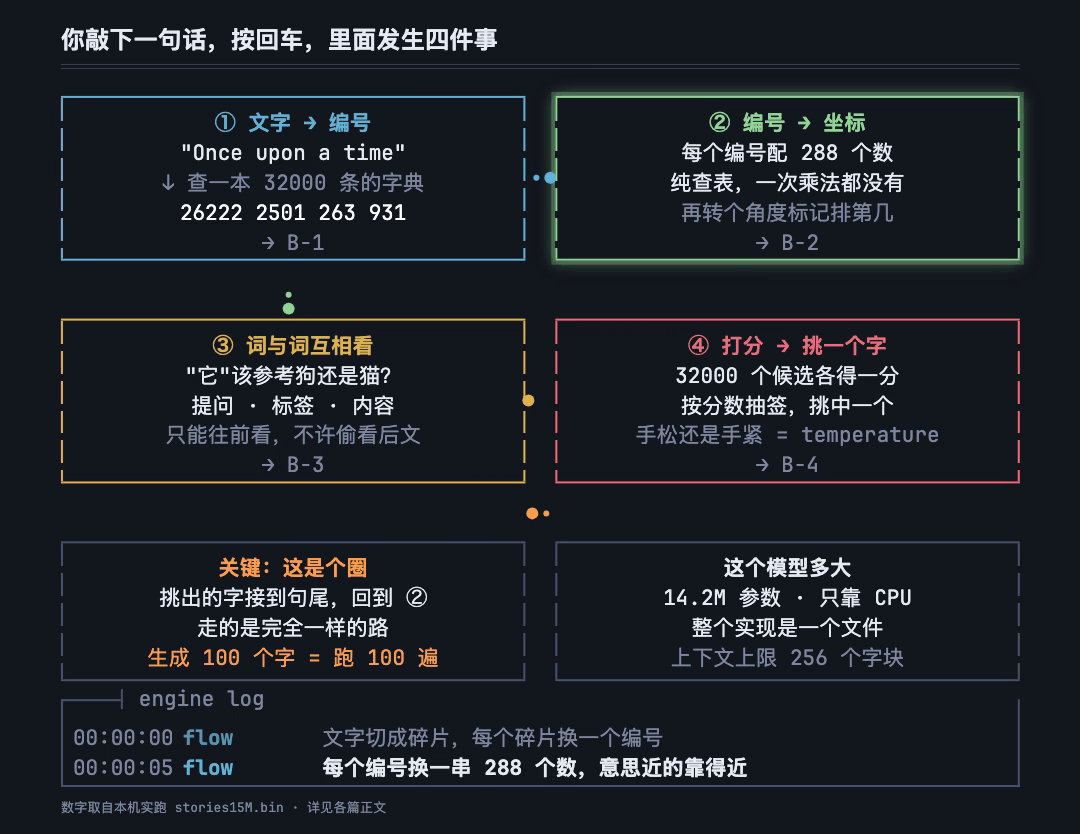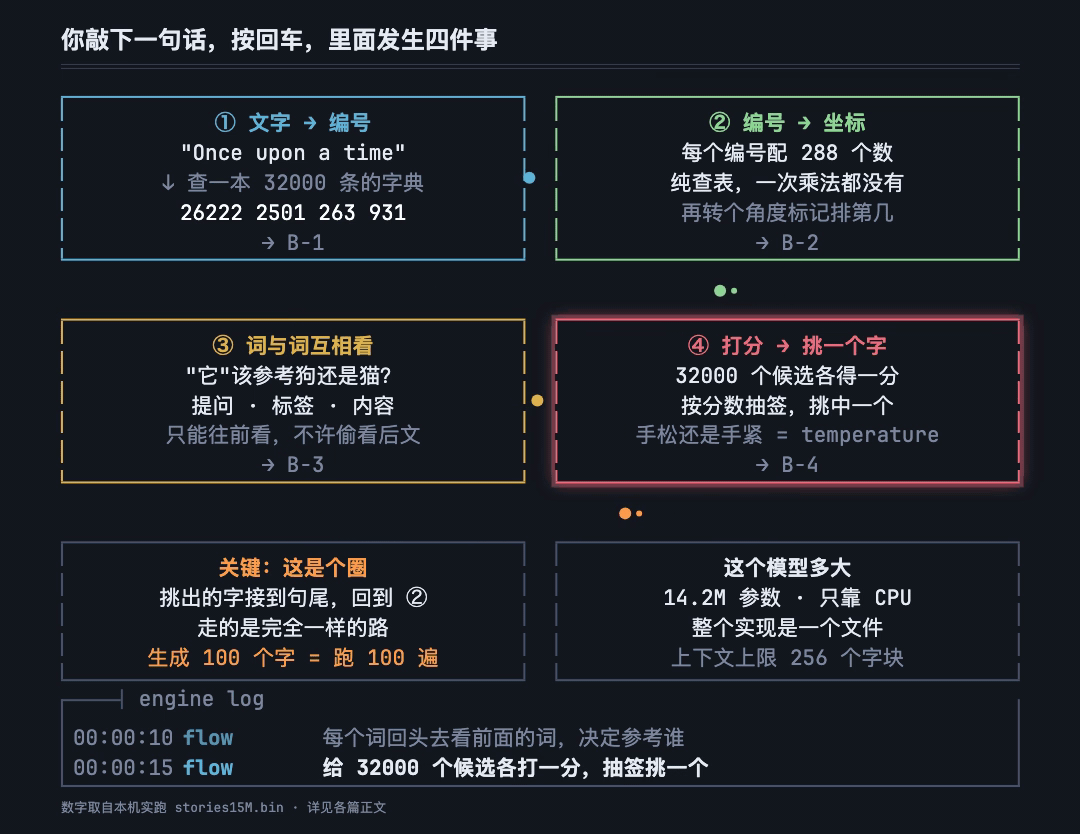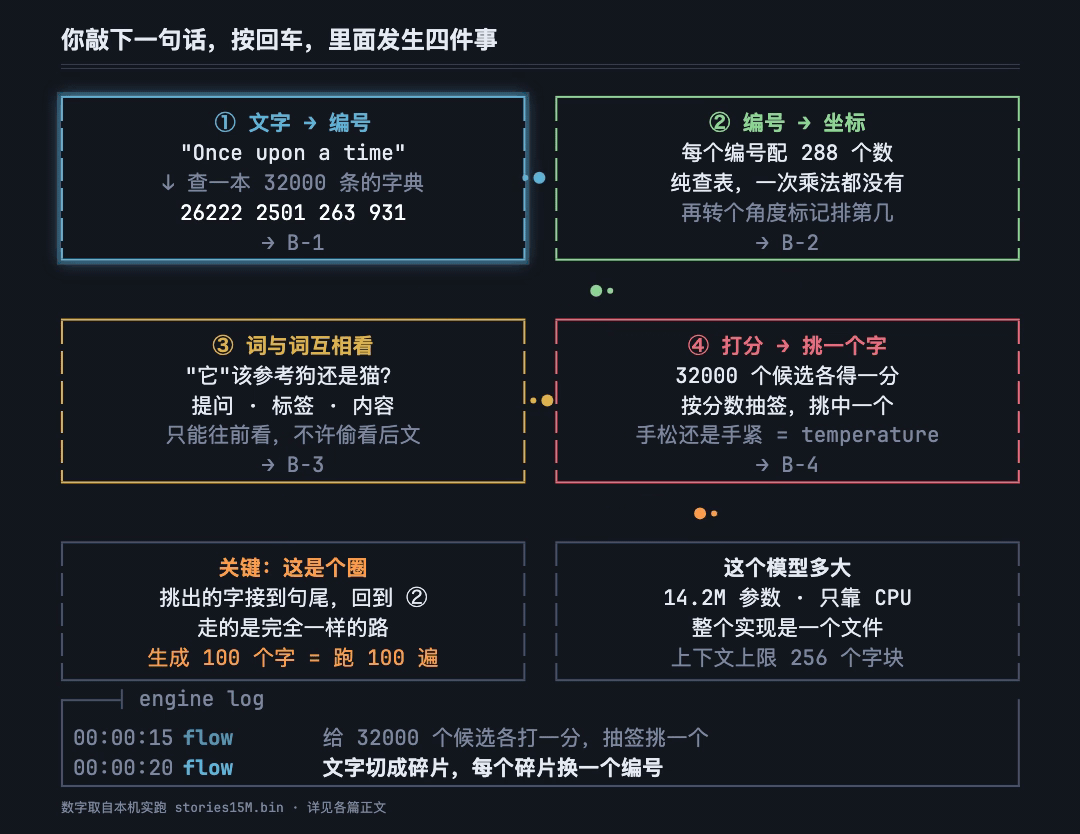
上面这块图一直在跑,画的就是这四道关口:哪一格亮起来,就表示数据正走到哪一步。
注意那条橙色箭头 —— 第④步挑出来的字,会接回句子末尾,再从第②步重新走一遍。
模型每走一圈只吐一个字;一句 100 字的回答,就是绕了 100 圈。
最该记住的一件事:最后那个箭头。
所谓"生成"没有魔法,就是把同一条路重复走很多遍, 每轮多吐一个字。你觉得模型在"思考连贯的故事",其实是它每次只能看见前面已有的全部文字, 然后猜下一个字。
图只是俯瞰。数据真正走起来,这四步各有值得一问的地方:
你敲的字,怎么被一本字典切成编号?
一串数字,凭什么"看起来像"意思?
代词怎么回头找到它指的名词?
挑字时为什么要在 32000 个候选里抽签?
接下来四章,一章一个问题,按数据走过的顺序讲。从图左上角那格开始。
文字怎么变成编号:一段话进入模型前经历了什么
总览图左上角那一格,是四道关口的第一道:查字典。
你输入"Once upon a time",模型凭什么能"看懂"?它不认识汉字,不认识英文字母,甚至不知道什么是"词",眼里只有整数。
所以这句话得先去换编号:每个文字碎片,到一本 32000 条的字典里领一个号。
这一步看着最没悬念,坑却最多 —— 空格跟着谁走?汉字为什么被切成半个?这一章将给你详细解释。
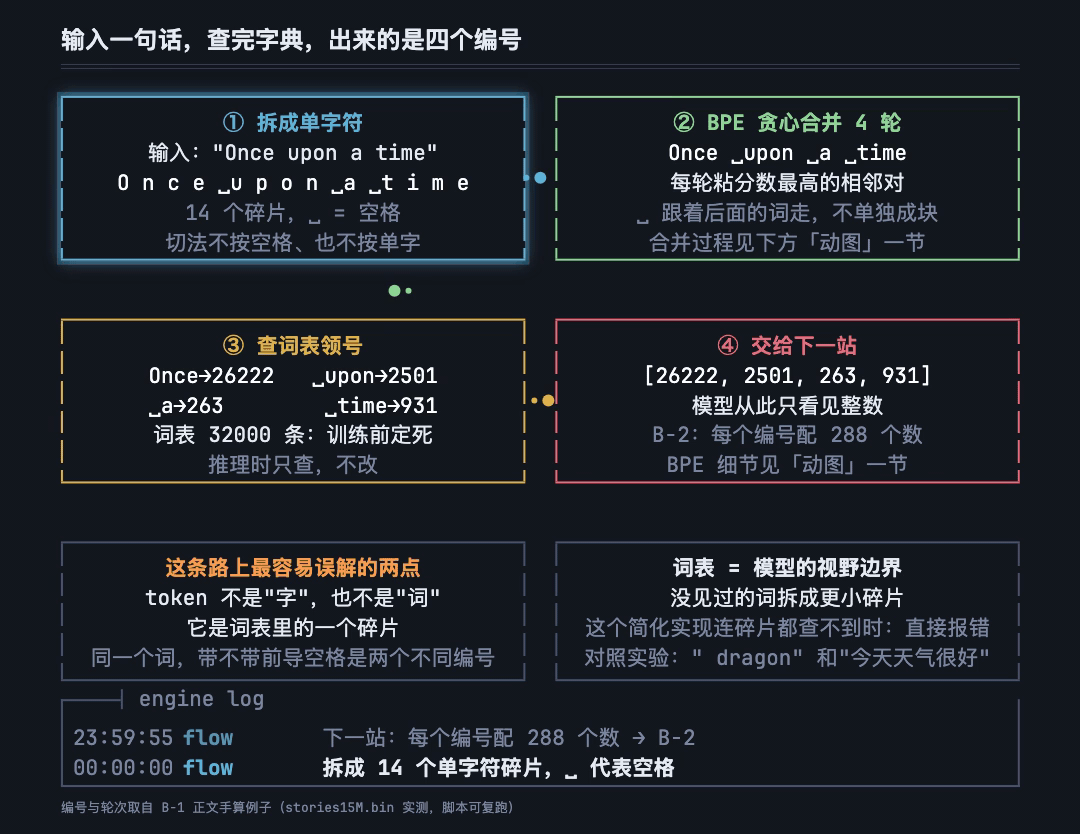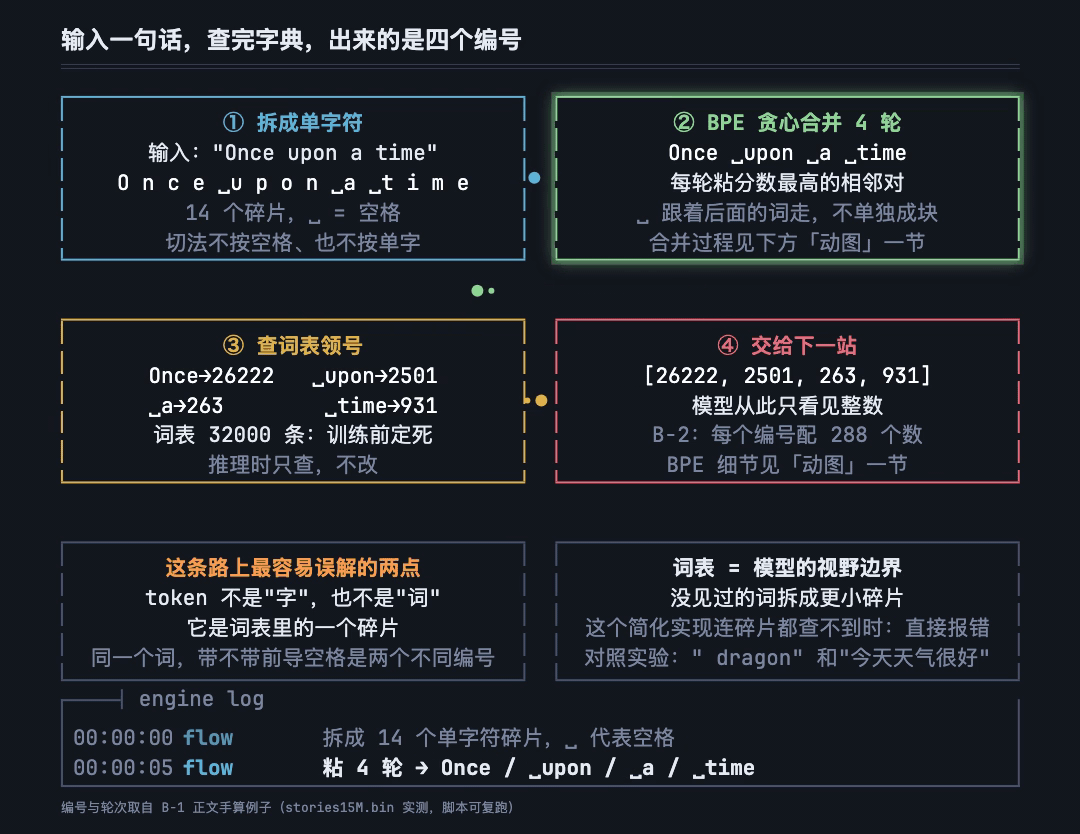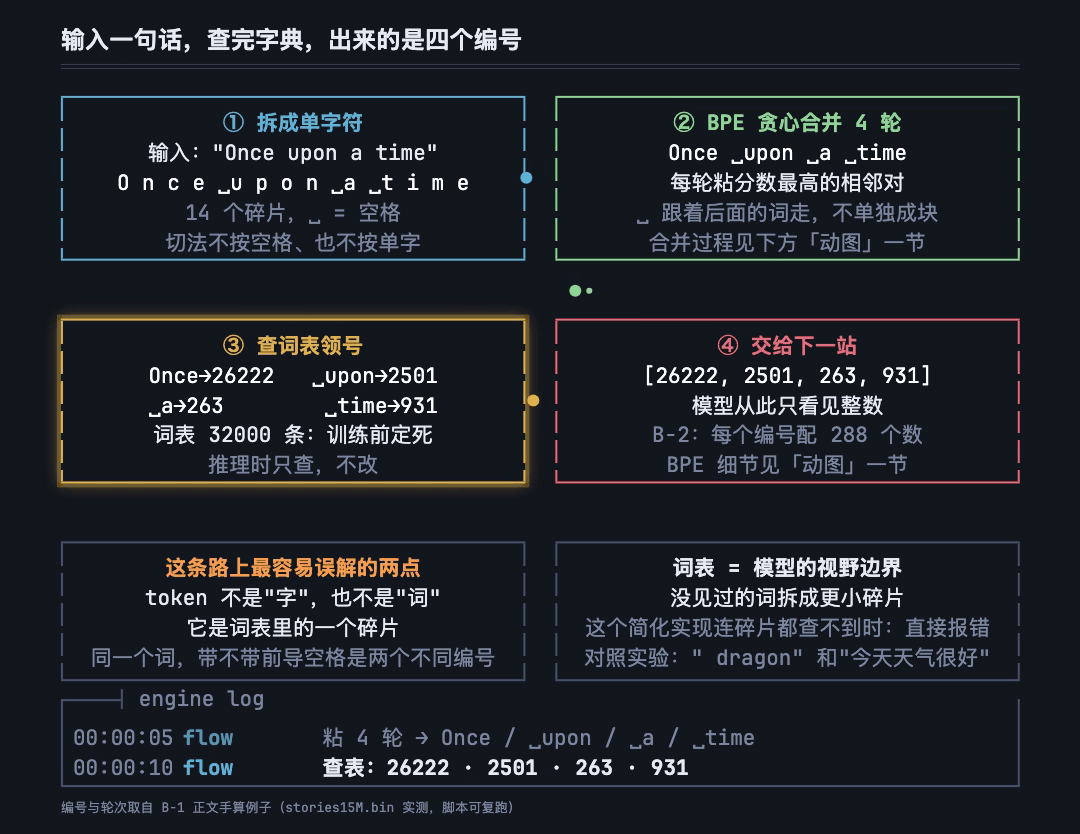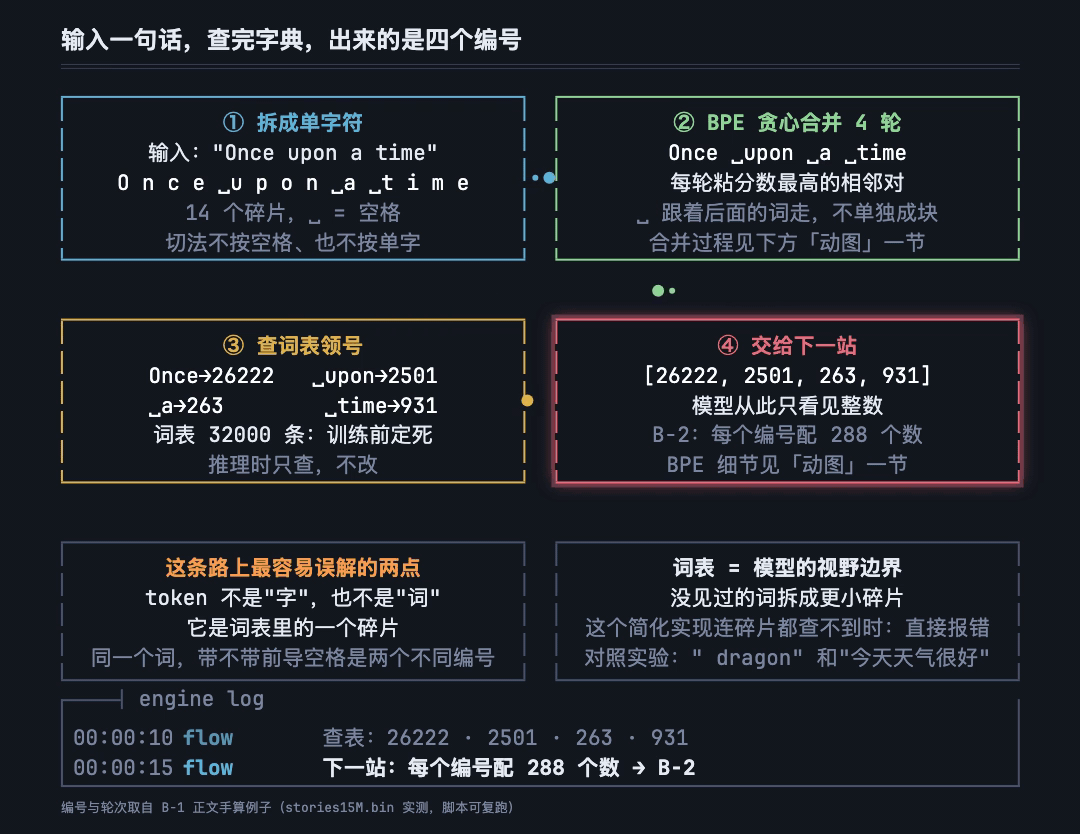
模型眼里没有文字,只有编号
你可能听过这样的说法:大模型的输入是一串 token。那 token 到底是什么?
把它想象成一本厚厚的字典——不是新华字典那种按拼音排序的,而是一本只列了 32000 个碎片的对照手册。
每个碎片旁边标了一个编号,从 0 到 31999。模型不认识碎片本身,它只认编号。
你打进去一句英文,第一件事就是查这本手册,把每个碎片换成对应的编号数字。
token 就是模型眼里的"一个字块",不一定是一个字,也不一定是一个词。
它可能是 一个字母、一个空格加几个字母、一整个短词、一个标点符号,甚至半个汉字。
词表就是那本 固定的手册:一共 32000 条,训练前就定死,推理时只查不改。
你输入的“Once upon a time”经过查手册后,变成了一串编号:
[26222, 2501, 263, 931]
为什么不直接一个字一个编号
最直觉的做法:把每个字母或每个汉字当成一个编号。26 个英文字母加标点符号,一共不到 100 个编号就够了。听起来很省事,但这会让模型"看"到的东西碎成渣。
想一想英文里的 the。按字母拆成 t+h+e 三个编号,这三个编号每一个都要把整个模型 从头到尾走一遍—— 计算量直接翻三倍。而且模型的"视野"是有限的:这个模型一次只能装 256 个编号,拆得碎,视野就被碎片占满,几句话就装不下了。如果 the 整个是一个编号, 一格顶三个字,计算和视野都省。拆得越碎,浪费在碎片上的计算越多,模型能看到的正文就越少。
那把每个英文单词都编成一个号呢?英语常用词好几万个,加上人名、地名、术语、拼写变体, 词表马上膨胀到几十万条。每多一条编号,模型里对应的那一层参数也跟着变多。词表太大, 字典本身就吃掉大量计算资源。32,000 条是折中:够大,常用的英文搭配能整块存进去; 够小,不会让字典本身变成模型的负担。
这不是拍脑袋的数字。stories15M.bin 这个模型文件里明确写着词表大小是 32,000, tokenizer.bin 文件里也刚好装了 32,000 条记录。BPE 就是在这个约束下长出来的一套 切分规则,下面马上讲。
换个角度看这个权衡:假设词表只有 1,000 条,那"anti"和"disestablishmentarianism" 这种稍长的词就必须拆成一堆碎片,模型每次都要从碎片里重新拼凑含义,浪费大量注意力 在"重新组装"上。反过来,如果词表有 500,000 条,虽然每个常用词都能一整个编号搞定, 但词表本身占据的参数量就会变得可观——相当于模型还没开始"思考",就已经背了一本厚得 要命的字典。32,000 是在"别拆太碎"和"别背太多"之间找的一个平衡点。
顺便看看:主流模型的词表多大
本博客的 llama2.zig 用 32,000 条——这正是 2023 年 Llama 2 的数字。看看这几年 的旗舰模型,词表普遍在变大:
| 模型(发布年份) | 词表条数 |
|---|---|
| GPT-3(2020) | 50,257 |
| Llama 2(2023) | 32,000 |
| GPT-4(2023) | 100,256 |
| Llama 3(2024) | 128,256 |
| Qwen2.5(2024) | 152,064 |
| GPT-4o(2024) | 200,000 |
| Gemma 2(2024) | 256,000 |
| DeepSeek-V4.1(2026) | 129,280 |
| Kimi K3(2026) | 160,000 |
为什么越做越大?主力是多语言。
3 万多条的词表几乎全是英文,中文会被切成半个字;20 万条的词表能把常用中文词甚至整个短语装进一条编号。同样一段中文,小词表要用 两三倍的编号数——刚才那笔"视野"账,碎片直接占掉一大截。
代价也是真的:每条编号,模型要配一行新坐标,通常还要再配一行打分权重。对千亿参数的旗舰模型,这点负担不算什么。
BPE:不是按空格切,是一轮一轮把高频邻居粘起来
BPE(Byte Pair Encoding)的中文可以叫"字节对编码",但你只需要记住它的核心动作: 从最小的碎片开始,一轮一轮把最常一起出现的相邻对合并成一个新符号。
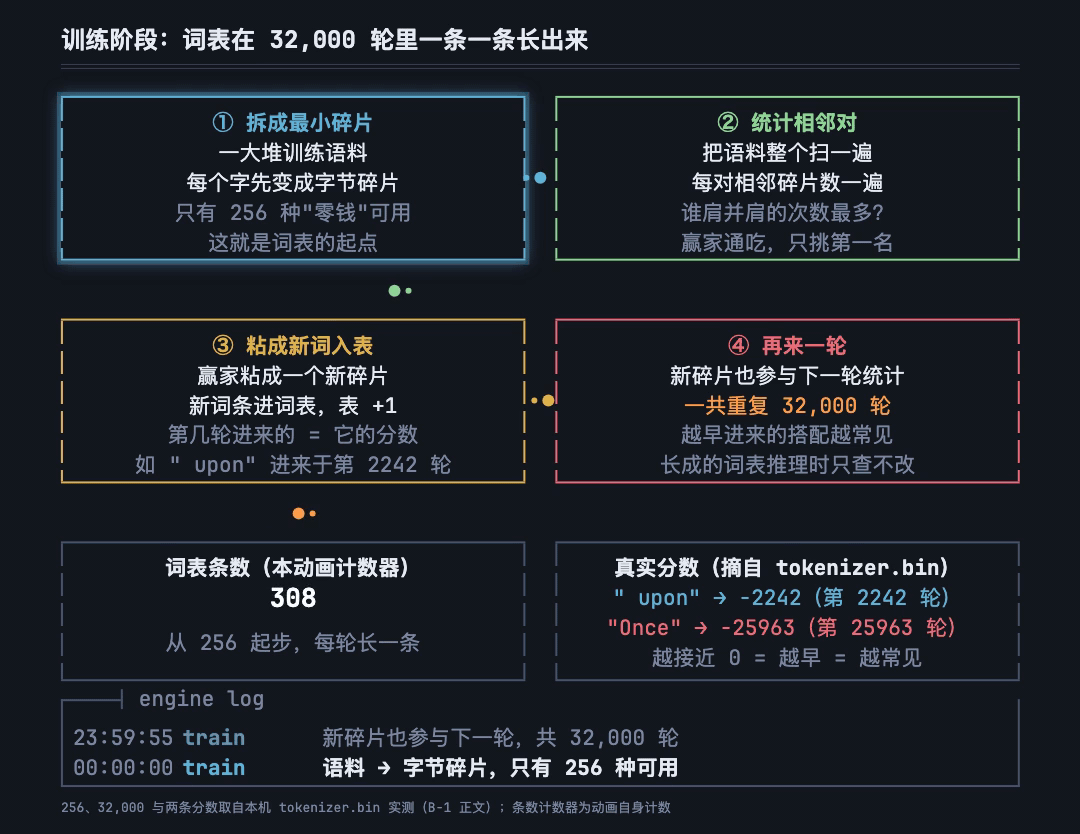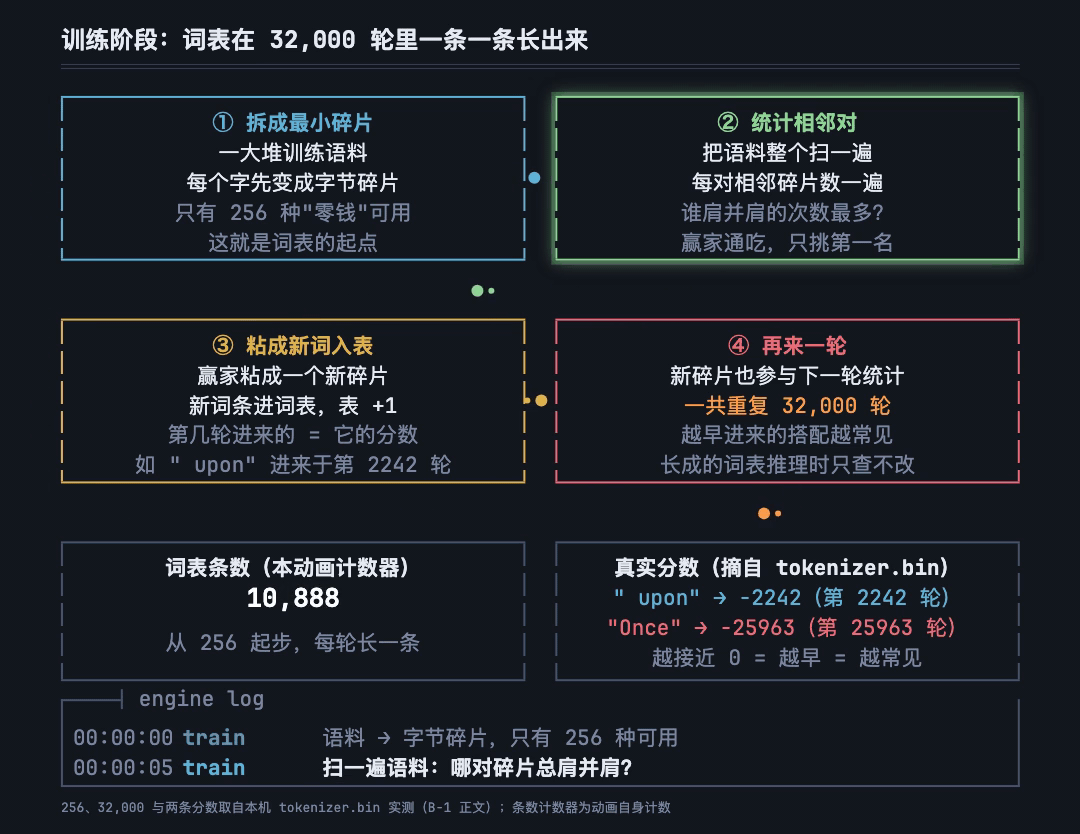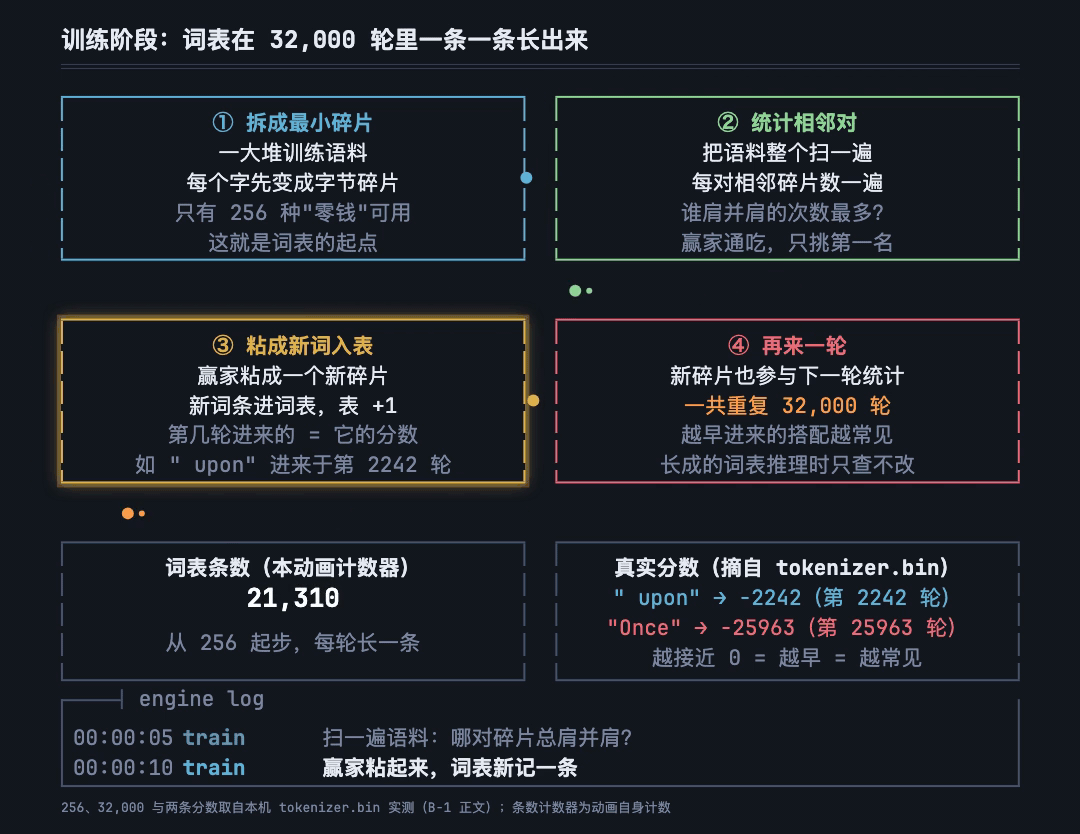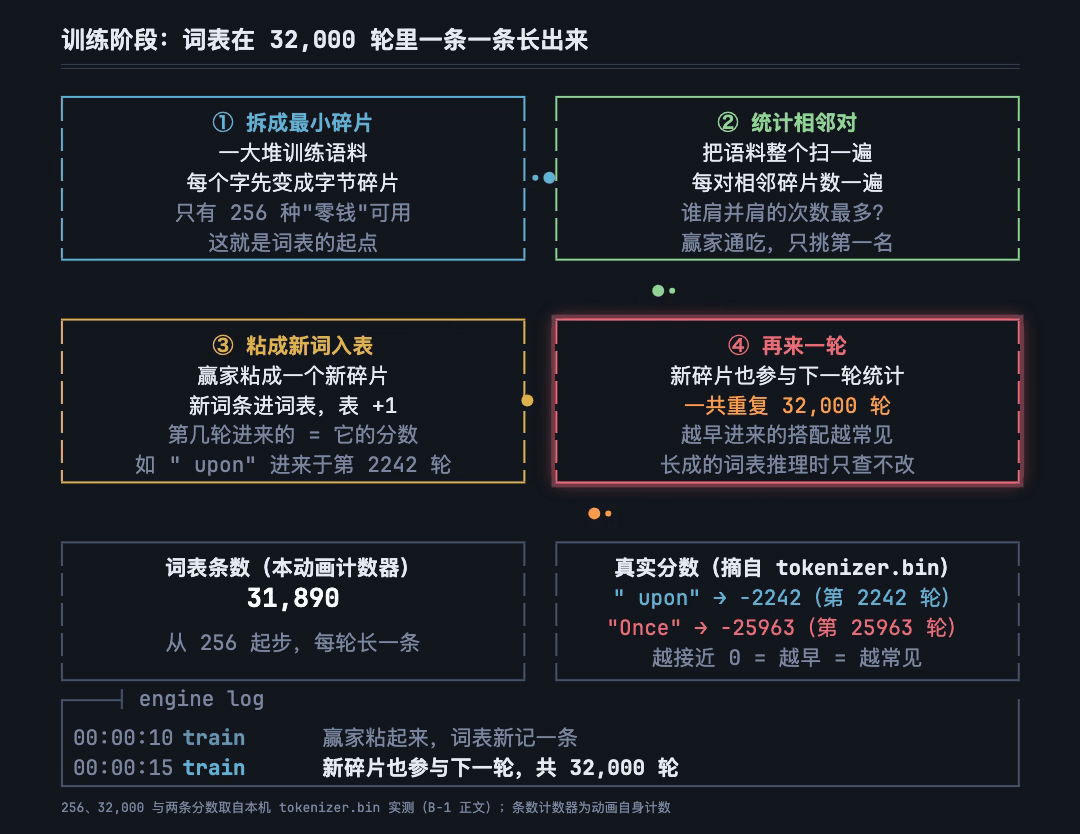
训练阶段就像一位编辑在编词典,一轮一轮地干:
把全部语料拆成最小碎片:英文拆成字母,中文拆成更小的编码单元。
扫一遍语料,数一数:哪两个碎片总肩并肩?
把最多的那对粘起来,变成新碎片,作为新条目加进词典。
回到第 2 步再数。重复 32,000 轮,词表就长成了。
为什么有效?常见的搭配会先一步晋升成"一个词"。
拿英文的 t 和 h 来说: 语料里 the、this、that、with 满天飞,第一轮的赢家就是 t+h,晋升成 th。 下一轮 th+e 最常见,the 晋升成一条编号。词表就这样一轮长一条。
每一轮合并都记录一个分数。越早被合并的组合,说明它在语料里出现得越频繁,分数就越高。这份"出现频率"的信息在推理时决定了该优先合并谁。
用真实数字手算一遍。
这句"Once upon a time"一开始被拆成最小的碎片:
O n c e ␣ u p o n ␣ a ␣ t i m e
其中 ␣ 代表空格。现在的词表里已经有 32,000 条碎片(训练阶段提前算好了),每条碎片带一个分数。
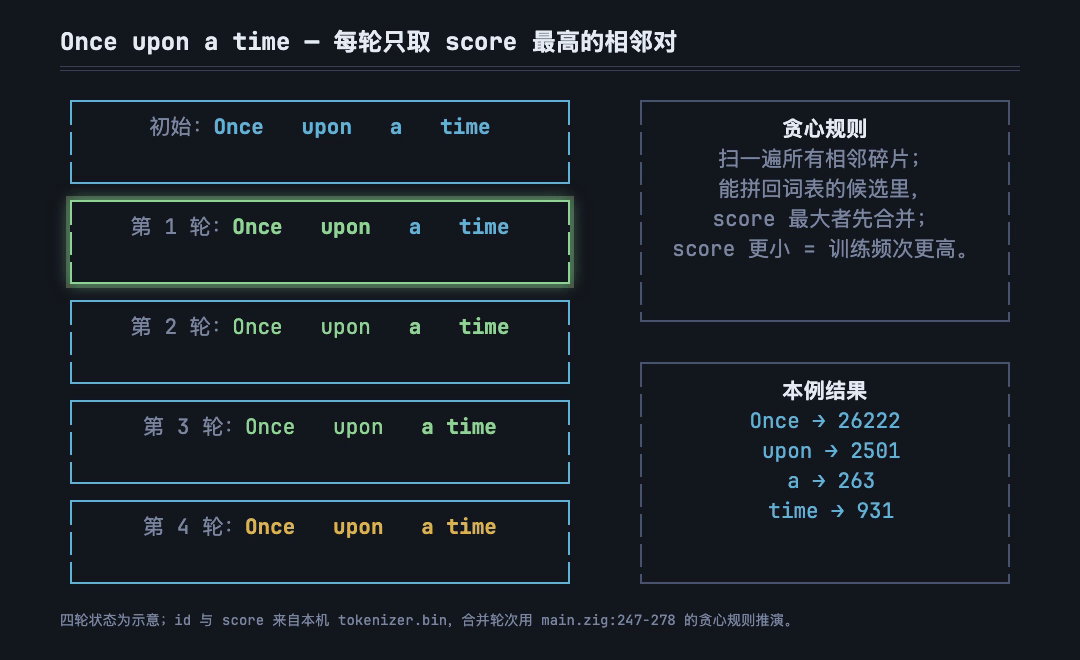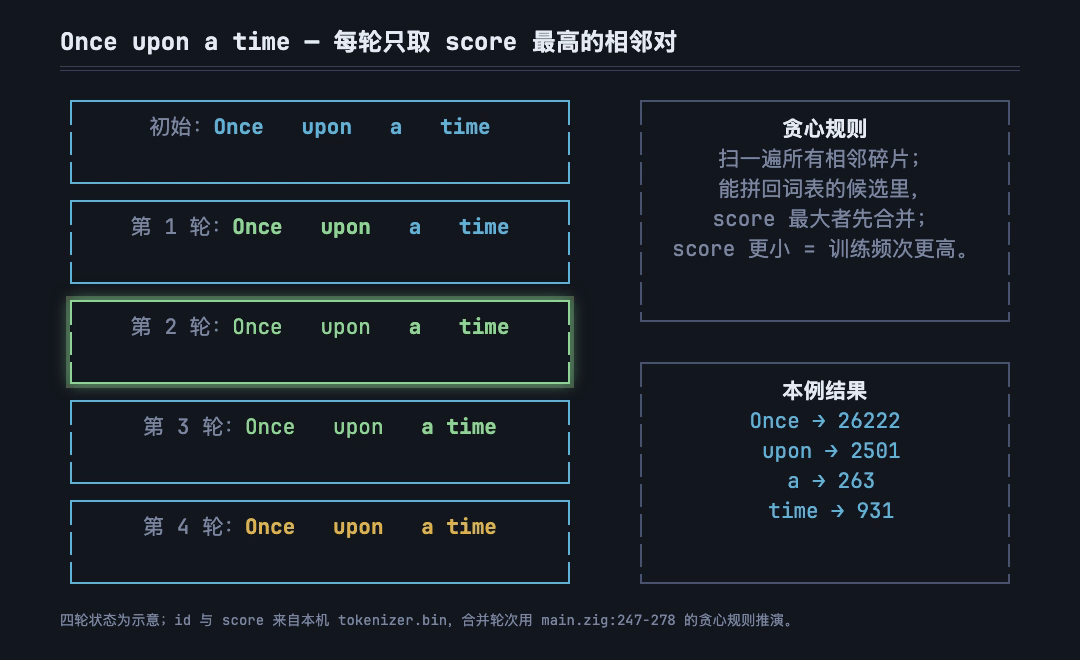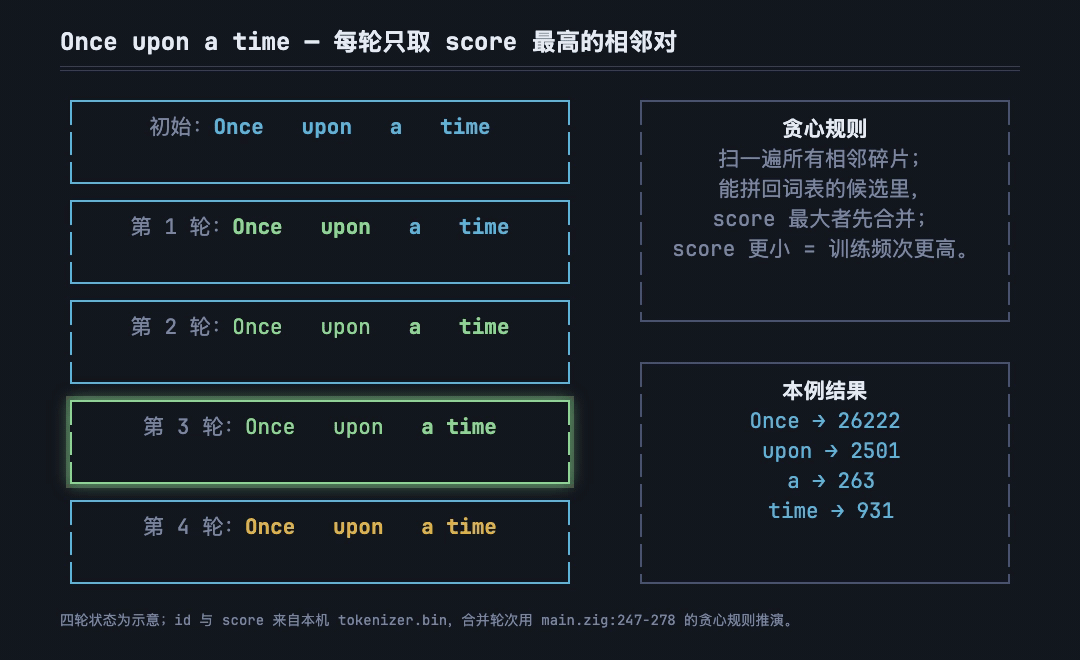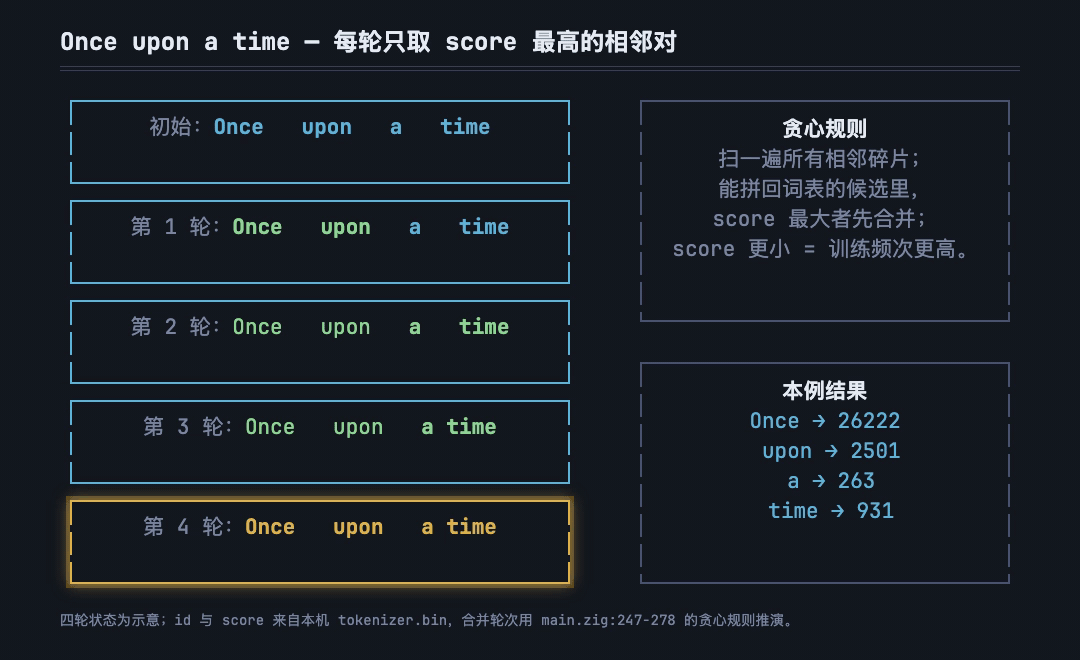
编码器每一轮扫一遍所有相邻碎片,看哪一对粘起来能在词表里找到、并且分数最高, 就把那一对合并。
这里的"分数最高"是整个机制里最关键的一环。
训练阶段,每一条碎片都是在某个轮次里被合并出来的,那次合并发生在第几轮,就决定了它的分数。
第 1 轮合并出来的碎片出现频率极高,分数最接近 0;第 31,999 轮合并出来的碎片非常罕见,分数可能低到 −30000。 推理时,编码器按同样的优先级来合并——先试高频组合,再试低频组合。这就保证了大多数 英文文本会被切成跟训练时类似的碎片。
这个例子恰好只需要四轮就能收敛到最终结果。
| 轮次 | 当前碎片 | 做了什么合并 |
|---|---|---|
| 初始 | O n c e ␣u p o n ␣a ␣t i m e | 还没合并,全是单字符 |
| 第 1 轮 | Once ␣u p o n ␣a ␣t i m e | 把 O+n+c+e 粘成 Once,它的分数最高 |
| 第 2 轮 | Once ␣upon ␣a ␣t i m e | 把 ␣+u+p+o+n 粘成 " upon" |
| 第 3 轮 | Once ␣upon ␣a ␣time | 把 ␣+t+i+m+e 粘成 " time" |
| 第 4 轮 | Once ␣upon ␣a ␣time | 没有更高分的合并了,结束 |
最终每个碎片都有一个编号:
Once → 26222
upon → 2501
a → 263
time → 931
空格不是多余的:为什么 token 前面常带空格
你可能会注意到上面的编号对照里," upon" 和 " time" 前面都有个空格。
这不是排版错误, 是故意设计的。
在英文里,词和词之间用空格隔开。如果把空格和词绑在一起做成一个 token(比如 " upon" 而不是单独的 “upon”),那么模型看到一个 token 就同时知道了"这里有个新词开始"和"这个词 是什么"。如果空格是单独的 token,模型每次都要先看到"空格"这个编号,再看下一个编号, 多了一步推断。
这个设计在英文文本里很自然:绝大多数词前面都跟着空格。但如果你只输入 time(没有 前面的空格),词表里可能没有不带空格的 time 这个碎片——只有带空格的 " time"。 这就意味着同样的字母序列,前面有没有空格,可能被切成完全不同的碎片。
那中文呢?中文的词之间没有空格,这招完全用不上。一个中文词能不能成为一个 token,只看训练时它有没有被粘进词表。
实测结果很干脆:这本词表里有 700 条单汉字,多字中文词一条都没有——连"天气" 都不在。所以这个模型眼里的中文是一个一个的字,词在哪里断开,全靠后面注意力 阶段去猜(B-3 讲)。英文的空格是字典递的捷径,中文没有这条捷径。
遇到词表里没有的词怎么办
词表只有 32,000 条,不可能覆盖所有语言的所有字符。这个最简实现的答案是:遇到查不到的字,直接报错退出。不假装能处理,不硬凑一个编号。
试一个中文例子。“今天天气很好"里,“今"和"天"和"好"都在词表里,但"气"和"很"不在。 实测结果:
| 字 | 在词表里吗 | 编号 | 分数 |
|---|---|---|---|
| 今 | 在 | 31482 | −31223 |
| 天 | 在 | 30408 | −30149 |
| 气 | 不在 | — | — |
| 很 | 不在 | — | — |
| 好 | 在 | 31076 | −30817 |
三个在词表里的字,编号都接近 30000,分数都在 −30000 附近——非常靠后,说明训练语料里 中文出现得极少。两个不在词表里的字,编码直接失败。这套实现在遇到词表外的字时不会 “兜底”,而是报错。
这不意味着所有模型都这样。更大的模型(比如 GPT 系列)用的是字节级 BPE,任何字符都能拆到最底层的字节单元,永远不会失败。但这个小型演示模型用了简化版,中文支持就是不完整。 把它当成一个教学示例就好——它诚实地展示了"词表覆盖不到的地方就是盲区”。
这也解释了为什么有些模型偶尔在中文任务上表现不如英文。如果训练语料里中文本来就少,词表里留给中文字符的名额就少,每个中文字的分数也会很低。分数低意味着这个碎片在合并优先级里排得很靠后,最终切分结果可能不够自然。再加上如果某些常用字压根没进词表, 整个句子都可能没法处理。词表的设计决定了模型对不同语言的友好程度——这不是模型 “聪明不聪明"的问题,而是训练前的资源分配问题。
词表文件长什么样
tokenizer.bin 这个文件总共 432,717 字节,装了 32,000 条记录。它的结构很朴素:
开头 4 个字节:记录了词表里最长的一条碎片有多少个编码单元(实测是 27)。
后面是 32,000 条记录,每条 = 分数(4 字节)+ 碎片长度(4 字节)+ 碎片内容。
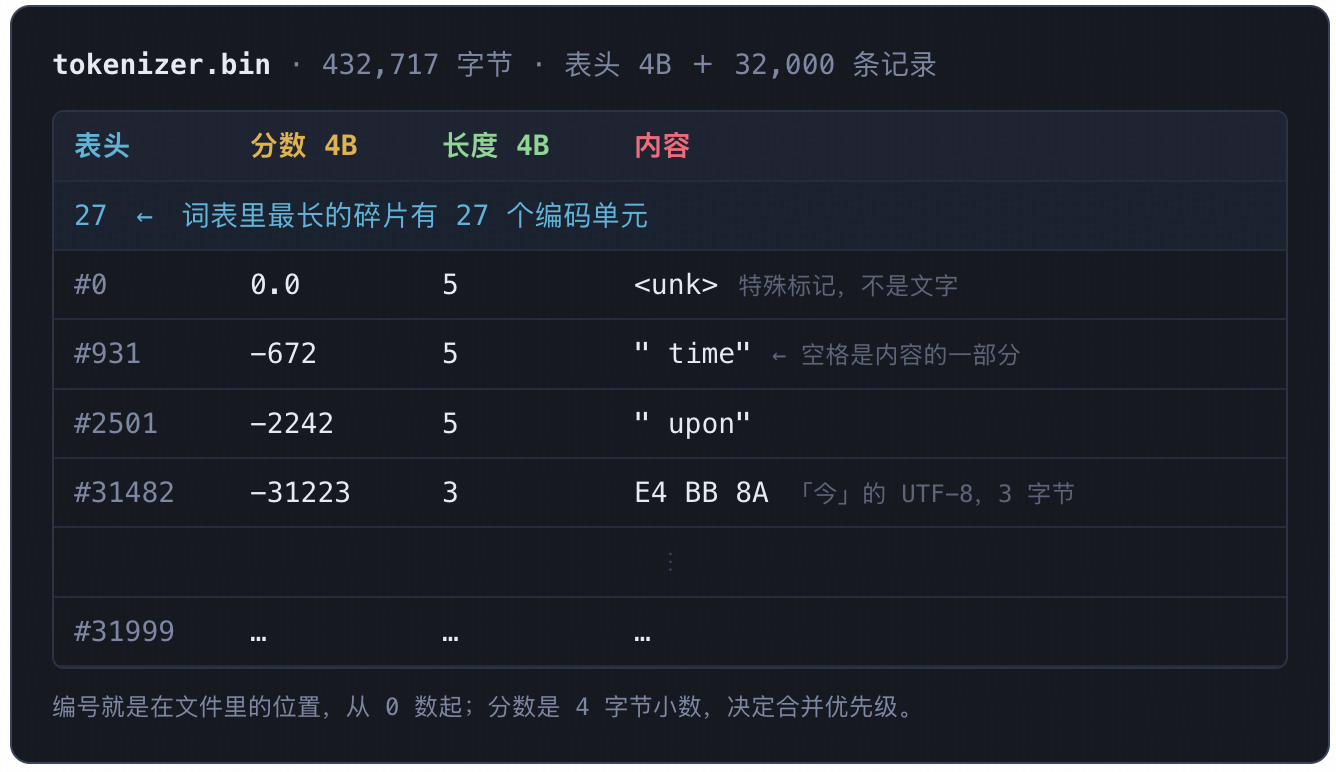
用比喻来说:这本字典的封面写着"最长词条 27 个字”,然后一页一页排下去,每页先写一个分数,再写这个词有多长,最后写内容本身。分数决定合并优先级,内容是碎片原文。
编号 0、1、2 是三个特殊标记,不对应任何真实文字。
编号 3 到 255 基本对应英文的单个字符(包括空格和标点)。编号 256 之后才是训练阶段合并出来的多字符碎片—— 越靠前, 说明它在语料里出现频率越高。
这里有个细节值得注意:编号 3 到 255 的碎片分数全部是 0。
它们不是训练出来的,而是出厂自带的最小单位,相当于"零钱”——无论什么输入,最差情况下都能拆成这些最小碎片。 编号 256 之后才是"整钞":训练阶段从语料里学出来的组合,分数越高表示用得越频繁。
编码器的目标就是尽量用大面额的整钞表示一段话,没有合适整钞时才退回零钱。
代码在做什么?
下面的代码是 BPE 编码的主循环
/// Given a string, find the index of the token that matches it exactly. If
/// no token matches, returns none.
fn lookup(self: *const Self, str: []const u8) ?u32 {
    for (self.tokens, 0..) |token, i| {
        if (std.mem.eql(u8, token, str)) {
            return @intCast(i);
        }
    }
    return null;
}


while (idx < input.len) {
    const utf_len = try std.unicode.utf8ByteSequenceLength(input[idx]);
    const codepoint: u21 = try std.unicode.utf8Decode(input[idx..][0..utf_len]);
    const encoded_len = try std.unicode.utf8Encode(codepoint, &utf_encoded_buffer);
    token_buf[token_end_idx] = self.lookup(utf_encoded_buffer[0..encoded_len]) orelse {
        return error.TokenNotFound;
    };
    token_end_idx += 1; // we have one more token now
    idx += utf_len; // skip over the utf8 sequence
}


while (true) {
    var best_score: f32 = -1e10;
    var best_id: u32 = 0;
    var best_idx: ?usize = null;

    // find the best token to merge
    for (0..token_end_idx - 1) |i| {
        // check if we are able to merge the token at i with the next token
        const catted = try std.mem.concat(fixed_allocator, u8, &[_][]u8{
            self.tokens[token_buf[i]],
            self.tokens[token_buf[i + 1]],
        });
        defer fixed_allocator.free(catted);
        if (self.lookup(catted)) |token_id| {
            if (self.scores[token_id] > best_score) {
                best_score = self.scores[token_id];
                best_id = token_id;
                best_idx = i;
            }
        }
    }

    if (best_idx) |best| {
        // merge the best token and shift the rest of the tokens down
        token_buf[best] = best_id;
        std.mem.copyForwards(u32, token_buf[best + 1 ..], token_buf[best + 2 .. token_end_idx]);
        token_end_idx -= 1;
    } else {
        // if we didn't find any tokens to merge, we are done
        break;
    }
}
第一步:切成最小碎片。 绿色代码块把输入按 UTF-8 codepoint(一个 Unicode 字符)逐个切开, 每个 codepoint 查一次词表拿 id。对 "Once upon a time",初始碎片就是 Once / " upon" / " a" / " time" 四个 codepoint 级碎片——这里它们恰好本身就在词表里。
第二步:反复挑最优合并。 剩下部分是核心:
橙色代码块,扫一遍所有相邻 pair,拼成候选字符串去词表里查(
lookup,main.zig:207-215)。蓝色代码块,能查到的候选里,取 score 最高的那一个。
绿色代码块,合并它,序列变短一格,回到开头再来一轮。
黄色代码块,没有任何相邻 pair 能拼回词表时,停。
编号怎么变成有含义的坐标
上一篇结束时,你手里有一串编号:26222 2501 263 931。
可编号本身没有意义——模型不知道 26222 是"Once"。
这一章走第二道关口:给每个编号配一串坐标(288 个数),意思相近的词坐标也靠近。
顺带解决两件事:标出每个词排第几;让原意别在层层加工中丢掉。
什么是坐标?
你在地图找一个地点,报两个数就够:经度、纬度。两个数定一个位置。
找一栋楼里的房间,要三个数:楼层、走廊号、门牌。几个数,就是几维空间。
坐标就是一组用来定位的数**。**
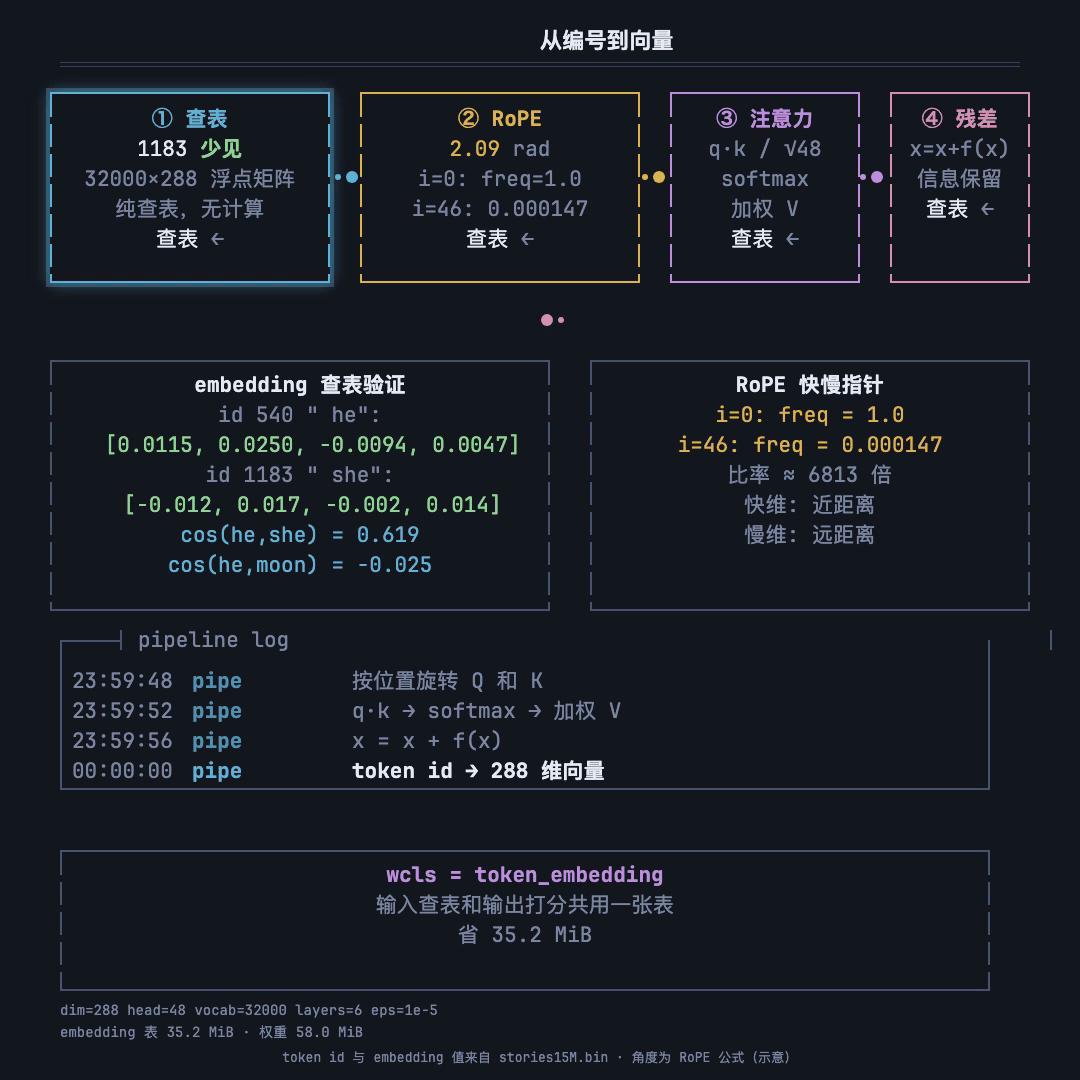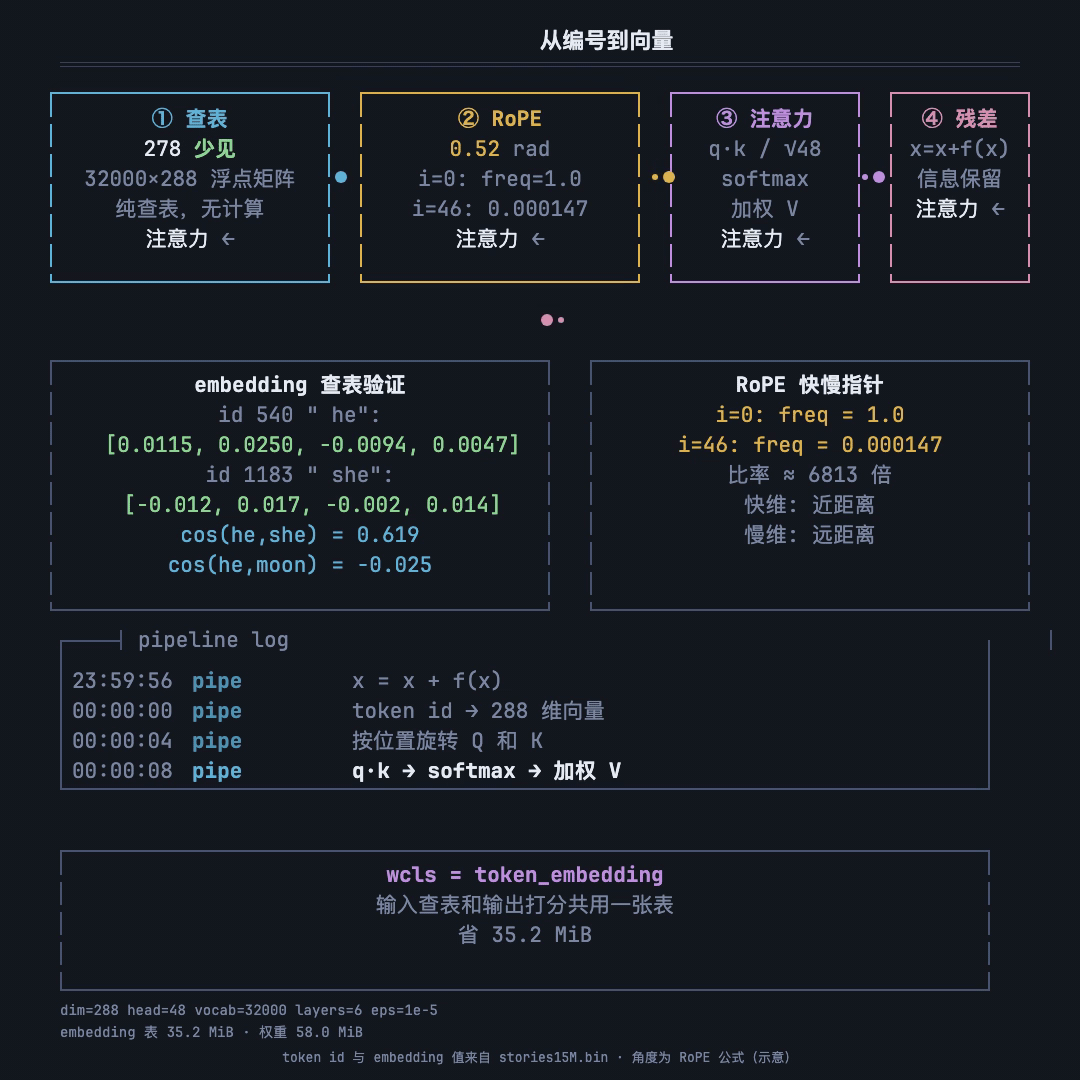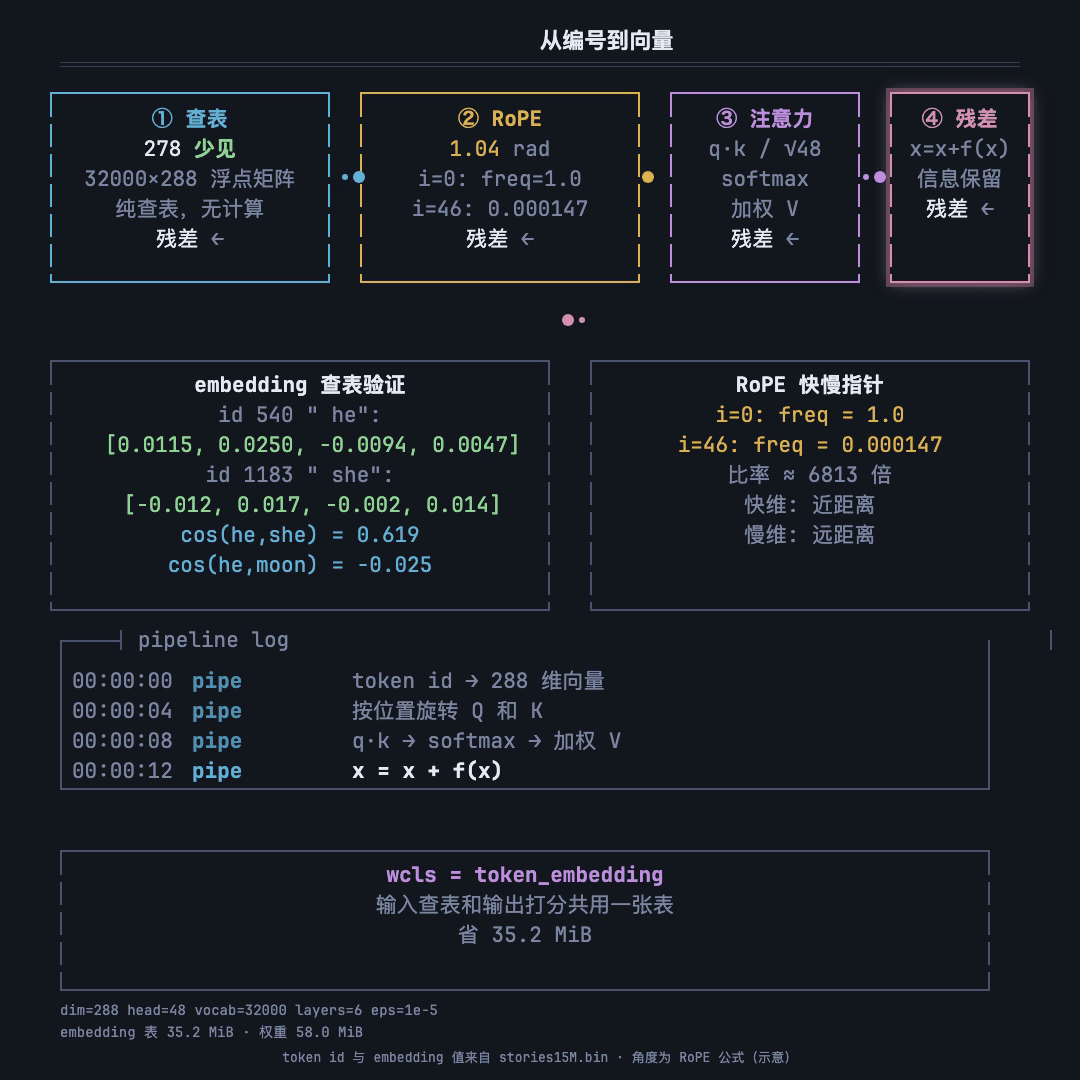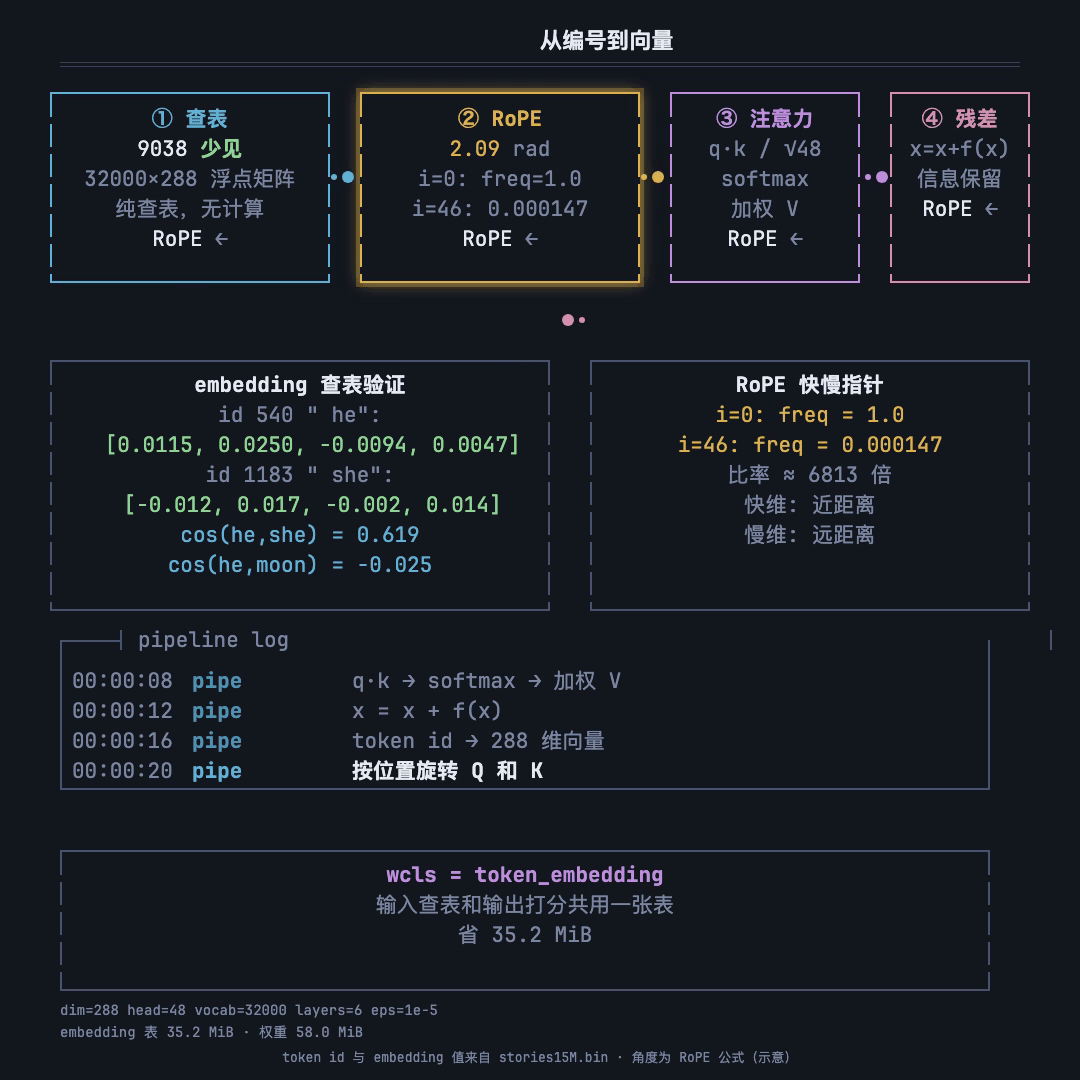
词也有坐标,只是维度多。这个模型给词表里每个编号配了一串 288 个数,比如编号 540(" he")开头四个是 [0.0115, 0.025, -0.0094, 0.0047]——真实模型文件里读出来的。
这 288 个数,就是这个词在一个 288 维空间里的位置。“Once"不再是一个词,而是一个点。
查表,不是计算
总览图右上那格绿色的,是四道关口的第二道:换坐标。
上一篇结尾,“Once upon a time” 被拆成了四个编号。编号只是编号——26222 不是"Once”,它只是一个行号。
这道关口要做的只有一件事:拿行号,去查这一行的内容。
这不是计算,是查表。
想象一本 32000 行的大表格,每行 288 个浮点数(带小数点的数)。
你把编号 26222 拿过去,它对应第 26222 行,你把那一行整行抄出来 —— 完成。
没有乘法,没有加法,没有"训练出一个结果"。
这跟查字典一模一样:你知道一个字怎么拼(编号),翻到那一页(那一行),把解释(288 个坐标数字)抄下来。区别只有一个:字典的解释由人编写;这里的坐标,则是训练时从大量文本里"挤"出来的。
每个词分到 288 个数字,这个 288 叫做这个向量的维度(就是"这串坐标有几个数")。
32000 个词,每个 288 个数,这就是 embedding 表。模型在第 0 层做的第一件事就是查这张表,把一串编号变成一堆坐标。
288 个数字到底代表什么
这是最容易被误解的地方:每一个单独的坐标没有明确的含义。没有人给它标注过"第 7 维是阴柔、第 100 维是金属"。你打开第 7 维的数字看,它不代表任何你叫得出名字的属性。
那意义在哪里?在相对位置里。
两串 288 个数字各自代表一个词,它们之间的"角度"反映这两个词在训练语料里的关系。
例如"蔡"和"坤"经常出现在相似的句子里,训练会让它们的坐标逐渐靠近。
打个比方:你走进一个满是人的房间,每个人的位置由 288 个坐标决定。
没有人告诉你"站在角落的是音乐家",但你发现搞音乐的人总是站在一起 —— 那是因为他们经常聊同一个话题,聊多了自然聚到一块。
每个坐标本身没有名字,但谁跟谁站得近传达了信息。
近到什么程度,可以用一个叫余弦相似度的指标来量:就是两串坐标的方向有多一致。1 表示完全同向,0 表示无关,−1 表示完全反向。
余弦相似度告诉你两个词在训练语料里出现在相似上下文中,但它不能告诉你这两个词在逻辑上有什么关系。
比如"猫"和"狗"的坐标可能很近(都是宠物、都出现在"喂食"“遛弯"这类句子里),但"猫会抓老鼠"和"狗会抓老鼠"在事实层面并不等价。
模型不知道"猫"和"狗"是两种不同的动物——它只知道这两个词经常出现在同一类句子里。
那么如何衡量2个坐标有多“靠近”呢?
我跑了下面的脚本,从实际模型文件(stories15M.bin)里读出真实数据。
先从词表确认编号:" he" 是编号 540," she" 是编号 1183," moon" 是编号 18786。
# 脚本(复制可跑):
# 文件开头 28 字节是模型参数(7 个整数),权重从第 29 字节开始
# 每个词的坐标占 288 × 4 = 1152 字节
# 第 tid 行的起点 = 28 + tid × 1152
import struct, math
HDR = 28; DIM = 288

def row(tid, f):
    f.seek(HDR + tid * DIM * 4)
    return list(struct.unpack('<%df' % DIM, f.read(DIM * 4)))

def cos(a, b):
    d = sum(x*y for x, y in zip(a, b))
    na = math.sqrt(sum(x*x for x in a))
    nb = math.sqrt(sum(x*x for x in b))
    return d / (na * nb)

ids = {' he': 540, ' she': 1183, ' moon': 18786}

with open('stories15M.bin', 'rb') as f:
    v = {k: row(t, f) for k, t in ids.items()}

print('id 540 first 4:', [round(x, 4) for x in v[' he'][:4]])
print('cos(he,she)  =', round(cos(v[' he'], v[' she']), 3))
print('cos(he,moon) =', round(cos(v[' he'], v[' moon']), 3))
输出如下:
id 540 first 4: [0.0115, 0.025, -0.0094, 0.0047]
cos(he,she)  = 0.619
cos(he,moon) = -0.025
cos(" he", " she") = 0.619,接近 1,表示这两个词的坐标方向很一致——它们在训练语料里确实出现在相似的上下文(都是人称代词,都接动词)。
cos(" he", " moon") = -0.025,接近 0,表示这两个词几乎不相关。数字站得住脚。
坐标是怎么算出来的
这些坐标是谁定的?训练定的。
先说清楚一件事:llama2.zig 这个仓库里没有训练代码。
1180 行全是推理——只读表,不改表。
博客用的 stories15M.bin,出自 Karpathy 的原版 llama2.c;它的训练代码(train.py + model.py)就在那个仓库里,我们可以简单了解一下训练过程。
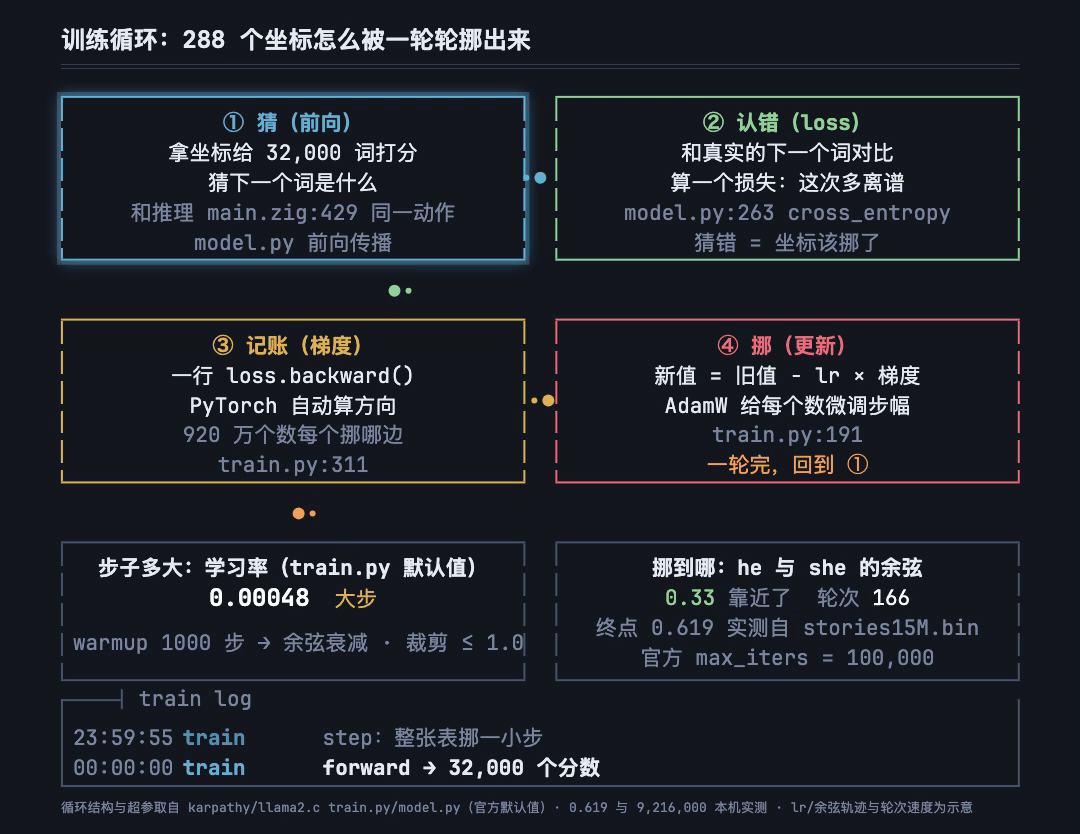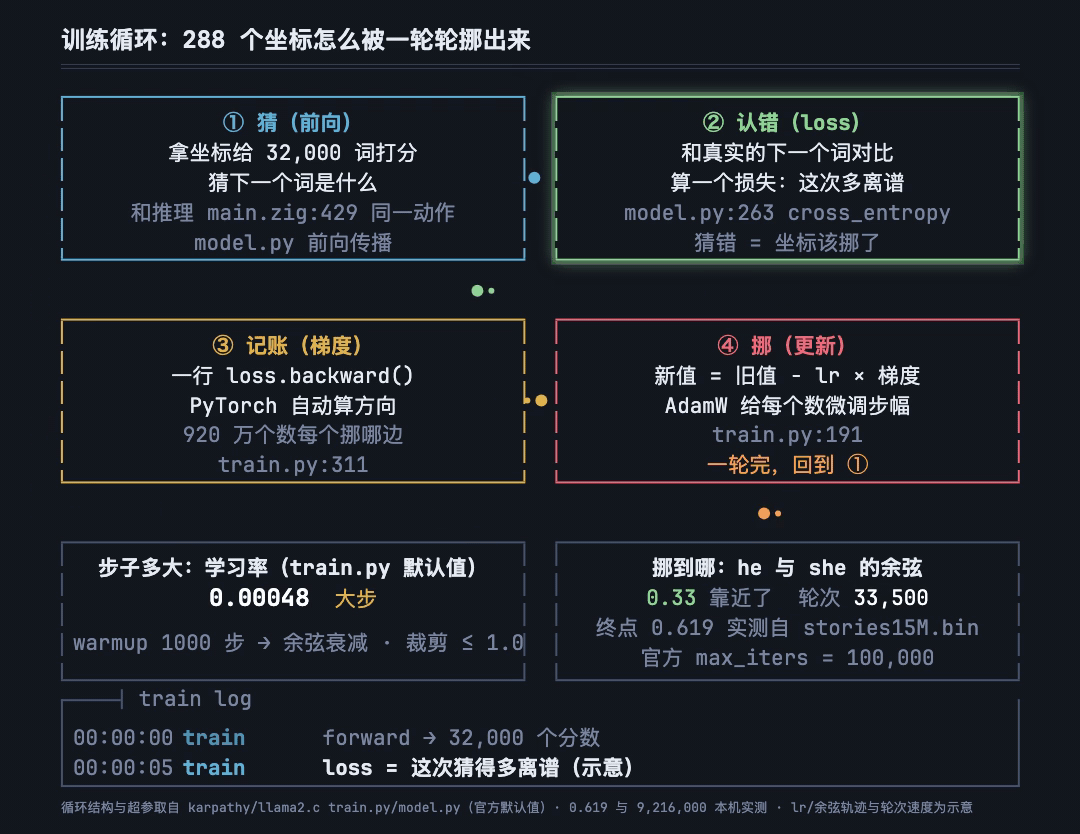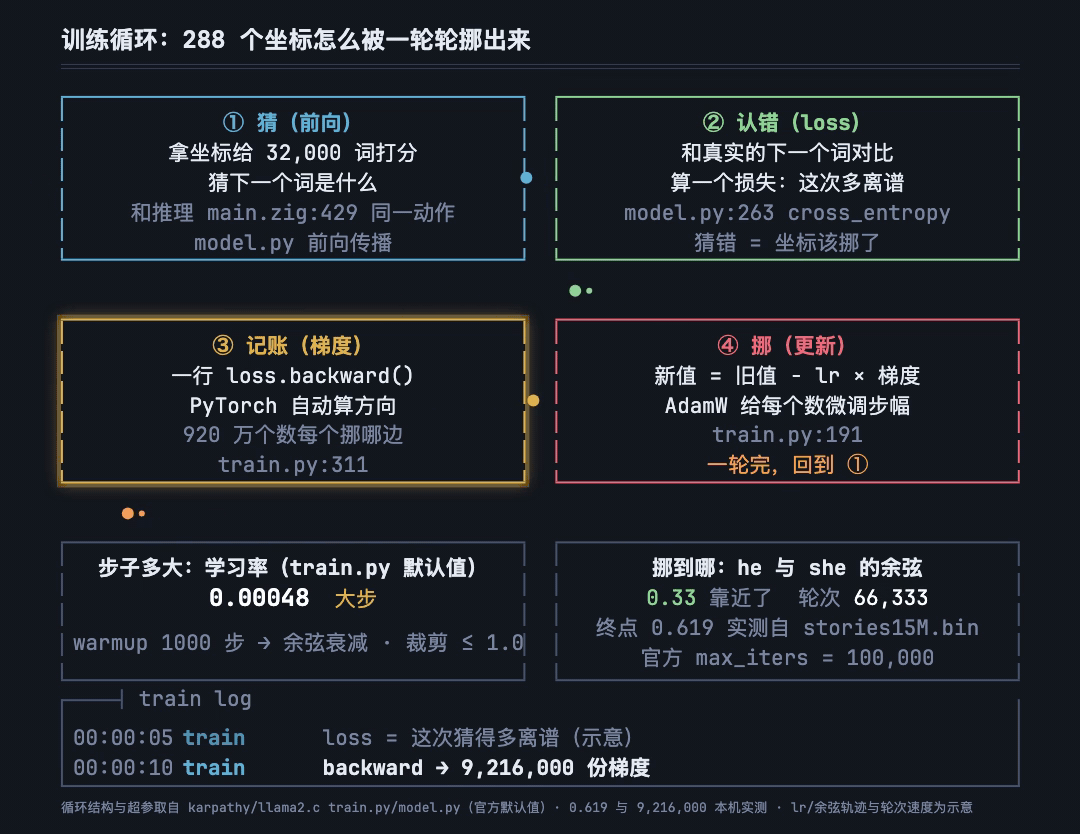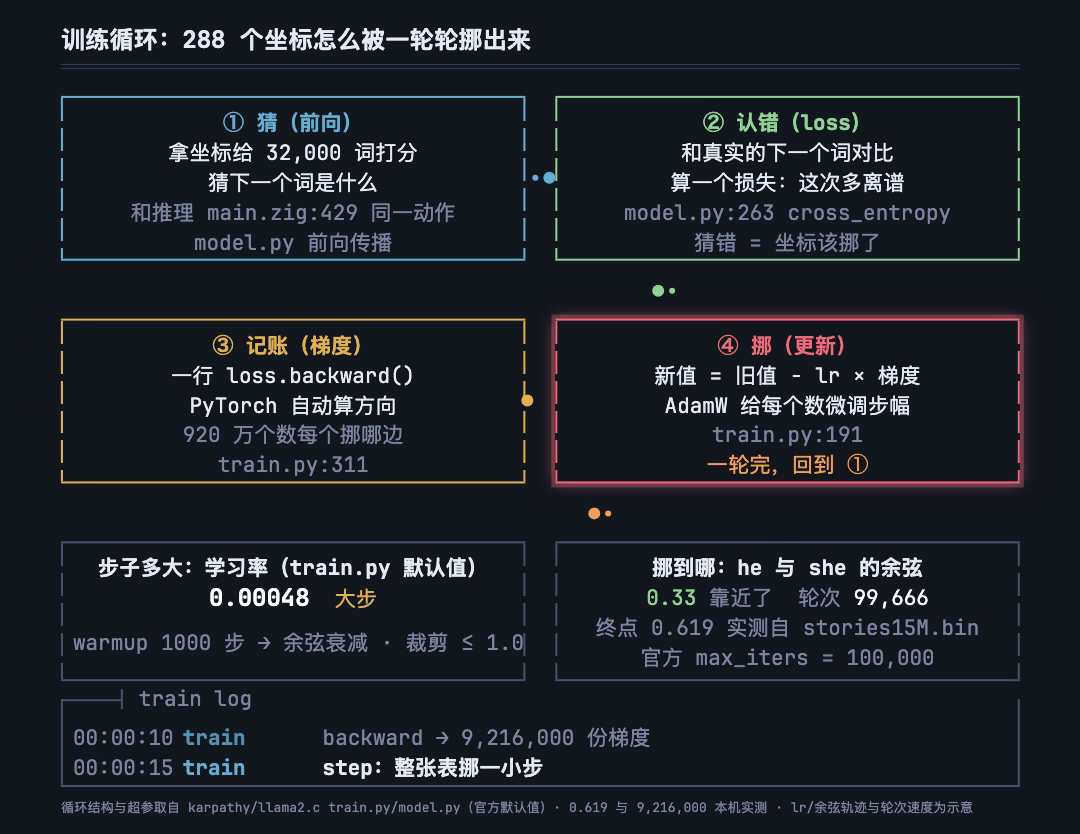
训练就是一个循环,每轮四拍:
猜:拿当前的坐标表,算下一个词的分数。跟推理时
main.zig:429那次打分是同一个动作。(表不是一成不变的:第 1 轮训练时它几乎是随机数,8 万轮时它已经算得很好。每一拍的猜用的都是此刻这一版的表)认错:把猜的结果和真实的下一个词对比,算出一个"损失”(
model.py:263)—— 这次猜得有多离谱。记账:一行
loss.backward()(train.py:311),PyTorch 自动算出表里每个数该往哪个方向移动。这个方向叫梯度,32000 × 288 个数每人一份。移动:每个数沿自己梯度的方向挪一小步:新值 = 旧值 − 学习率 × 梯度(
train.py:191)。学习率从大变小(train.py:229,余弦衰减):早期步子大,词云快速聚拢;后期只微调。
4拍各自展开说一句。
分数是乘出来的。 32,000 个分数,算法是同一种:对应相乘、再全部加起来。
意图向量 288 个数,词表某一行也是 288 个数,一一 配对相乘,288 个积加成一个总数,就是这行词的分数。
两个数同号且都大,乘出来为正,加分;一正一负,乘出来为负,扣分。
每猜一次字要做约 920 万次乘加,main.zig:485 的注释说它占了推理总时间的九成。
# 分数 = 对应相乘、全部加起来。3 维迷你版,手能算过来:
x = [0.2, 0.5, -0.1]        # 意图向量
w = [0.1, 0.6, 0.0]         # 词表某一行
score = sum(a * b for a, b in zip(x, w))
# 0.02 + 0.30 + 0.00 = 0.32   → 方向一致,高分
w_bad = [0.1, -0.5, 0.0]
# 0.02 - 0.25 + 0.00 = -0.23  → 对着干,低分
# 真实版只是数字变多:每行 288 个数,全表 32,000 行——
scores = [sum(a*b for a, b in zip(x, row)) for row in table]
损失看正确词。 32,000 个分数先过一道 softmax,变成 32,000 个概率。
所有概率加起来等于 1,分数高的词拿走大头。
然后只看正确答案那一项:损失 = 正确词概率取负对数。
猜得又准又自信,概率接近 1,损失接近 0。
正确词要是只分到 1% 的概率,损失约 4.6 —— 训练目标就一句话:把这个数变小。
from math import exp, log
def softmax(v):                    # 分数 → 概率:大的占大头,总和=1
    e = [exp(t - max(v)) for t in v]
    return [t / sum(e) for t in e]
p = softmax(scores)                # 32,000 个概率
loss = -log(p[correct_id])         # 只看正确词那一项,取负对数
# 又准又自信 p=0.9 → 0.11 | 蒙对 p=0.5 → 0.69
# 正确词只分 1% → 4.61   | 自信地猜错 → 9.2
记账就是分摊责任。 损失是一个数,却是 920 万个数"合写"的。
loss.backward() 干的事:从损失出发沿原路倒推,给每个数算一个梯度—— 你稍微变大一点,损失会升还是会降?
梯度为正,说明你偏大,该往小挪;为负则相反。
绝对值越大,损失对你越敏感,越该多挪。
import torch
w = torch.tensor(5.0, requires_grad=True)   # 一个参数,真实答案是 3
loss = (w - 3) ** 2                         # loss = 4
loss.backward()                             # 记账:w 的梯度?
print(w.grad)                # 4.0 = 2×(5−3) → w 偏大,往小挪
w -= 0.1 * w.grad            # 0.1 = 学习率。挪:5 → 4.6,loss 4 → 2.56
步子走余弦曲线。 学习率决定每步挪多大,train.py 默认起点 0.0005、前 1000 轮线性升温。
之后沿余弦弧线滑落到 0,一共 10 万轮(train.py:229)。
开头敢迈大步,因为表还是随机的,往哪挪都有收益。
后面必须收小,因为词云已经聚拢,大步会来回震荡。
选余弦而不是直线下降,图它两头平缓:起步不突跳,收尾不戛然而止。
from math import cos, pi
def get_lr(it):                    # train.py:229 官方逻辑,简化版
    if it < 1000:                  # 热身:线性升温
        return 0.0005 * it / 1000
    r = (it - 1000) / 99000        # 进度 0 → 1
    return 0.0005 * 0.5 * (1 + cos(pi * r))
# 第 1000 轮 0.0005(峰值)→ 第 5 万轮 0.00025 → 第 10 万轮 0
32000 × 288 × 4 字节 = 一半以上的存储
先算一笔账。embedding 表的规模是:
32000 个词 × 每词 288 个浮点数 = 9,216,000 个数字
每个浮点数占 4 字节 → 36,864,000 字节 ≈ 35.2 MiB
这个模型的所有权重加起来约 60,816,000 字节(约 58.0 MiB)。
也就是说,光"查字典用的那张表"就占了整个模型的 60.6%。
剩下不到 40% 的参数负责后面所有的"思考"——注意力、位置编码、六层加工、打分。
这个比例说明一件事:这个模型很大一块"脑子"其实是一本字典。
要理解它的体积构成,先要理解字典本身有多大。
旗舰模型的字典有多大?
60% 只是小模型的比例。把几家旗舰模型官方配置(HuggingFace 上的 config.json)里的数拉出来,算法完全一样。B-1 比过词表条数,这次加上"每个词几个数"。旗舰训练时一个数占 2 字节(bf16):
| 模型 | 词表 | 每词维度 | 表参数量 | 表体积 | 占整模型 |
|---|---|---|---|---|---|
| llama2.zig(本篇) | 32,000 | 288 | 920 万 | 35.2 MiB(f32) | 60.6% |
| Mixtral 8x7B | 32,000 | 4096 | 1.3 亿 | 0.26 GB | 0.28% |
| Gemma 2 27B | 256,000 | 4608 | 11.8 亿 | 2.4 GB | 4.3% |
| Qwen2.5 72B | 152,064 | 8192 | 12.5 亿 | 2.5 GB | 1.7% |
| Llama 3.1 405B | 128,256 | 16384 | 21.0 亿 | 4.2 GB | 0.5% |
| DeepSeek-V3 | 129,280 | 7168 | 9.3 亿 | 1.9 GB | 0.14% |
| Kimi K2 | 163,840 | 7168 | 11.7 亿 | 2.4 GB | 0.11% |
不难发现:
字典长停了。 旗舰的 embedding 表全卡在 0.3~4 GB 之间。Llama 3.1 的表有 21 亿参数,听着大,其实只占整模型 0.5%。“脑子一半是字典”,只是个头小才有的事。
猛涨的是维度。 词表从 32,000 涨到 16 万,也就 4~5 倍。每词的坐标却从 288 涨到 16384,涨了 57 倍。旗舰的字典不比本篇的多几行,是每行长了 57 倍。
模型参数越大,字典占比越小。 Gemma 2 是稠密架构,字典还能占 4.3%。MoE 那两家的大头全在专家层,字典只剩 0.1%。字典占比和模型大小成反比——模型越大,“查字典"越只是进门那道手续,真正的体量在后面的层里。
位置:狗咬人和人咬狗怎么区分
现在每个词都有自己的 288 维坐标。
但还有一个问题:模型只知道"这些词都在场”,不知道谁先谁后。
想想这两句话:狗咬人 vs 人咬狗。用到的词完全一样,意思天壤之别。
如果你把三组坐标交给注意力层,它只会算"狗的坐标和人的坐标有多相关"—— 算出来的结果在两句话里一模一样。模型不知道是"狗在做动作"还是"人在做动作"。
所以必须额外注入位置信息。
所以必须额外注入位置信息。LLaMA 用的方法叫 RoPE(旋转位置编码)。
先说清它转的是什么:288 个坐标两两配对( 因为旋转这个动作天生是二维的,一根针要指个方向,得有两个数),正好 144 对,每一对都能画成平面上的一个箭头。
“坐标里藏着指针”,说的就是这 144 根针。
规则一句话:排第几,针就转几倍。
第 p 位的词,每根针各转 p × 自己的转速,转速各不相同。旋转只换方向、不改长度,词义不受伤。
位置 0 所有针指原方向;位置 1 快针转 57°;位置 10 快针转了 1.6 圈,中针才挪 6°,慢针纹丝不动。
最容易被误读的是"夹角"。
比的对象不是同一个词内部两根针,而是两个词在同一维度上的一对针。
第 3 位和第 7 位的两个词,快针夹角 = (7−3)×57°:绝对位置消掉了,夹角里只剩"隔多远"。
注意力只问一句:两针方向一致吗?—— 所以它天生看得见距离,看不见绝对位置。
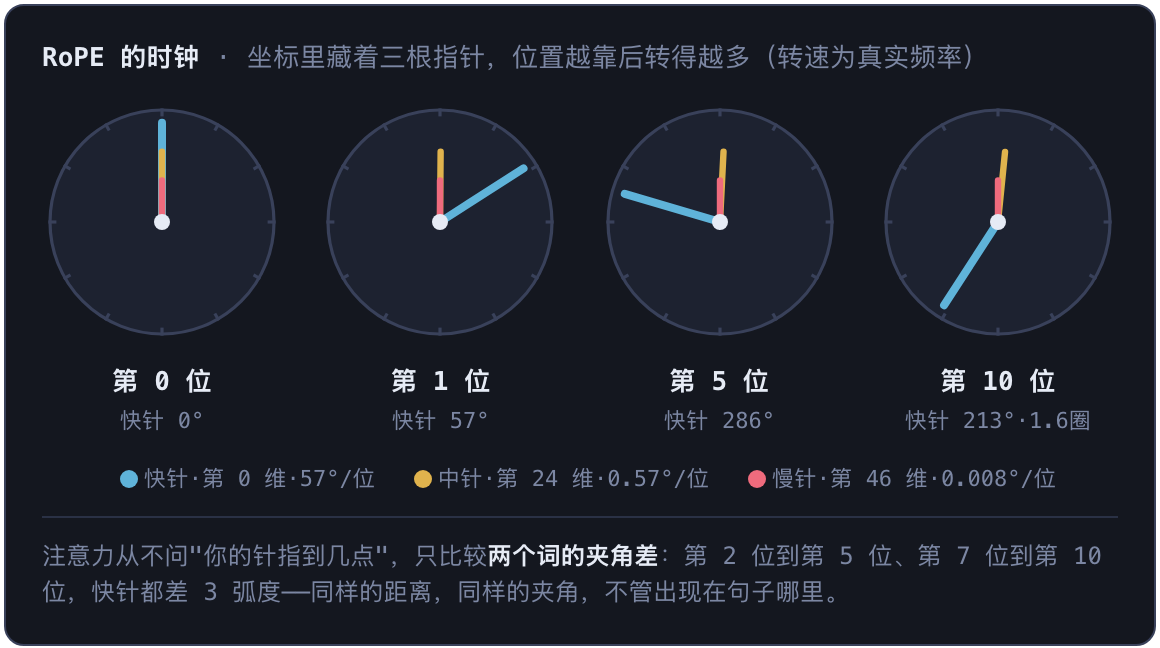
"狗咬人" 里"狗"在第 0 位,"人咬狗" 里"狗"在第 2 位——同一个"狗"的坐标,转过的角度不一样,注意力层就能区分出它在两种语序里扮演的角色不同。
为什么不同维度转得快慢不同?如果所有维度的转速一样,就只需要一根指针,远近距离都混在一起。
RoPE 的做法是给不同维度对分配不同的转速(维度编号越小转得越快,而且是指数级衰减):
第 0 维对转得最快:相邻两个位置,角度差就很大。适合分辨紧挨着的词的关系。
第 46 维对转得极慢:位置差 10 个 token,角度几乎没变。适合编码"隔了很远但有关联"的词的关系。
真实的数字:第 0 维的转速是 1.0(每个位置转 1 弧度),第 46 维的转速约 0.000147。比率约 6813 倍。从快到慢排成一条渐变的谱,覆盖从"紧邻"到"整段话"的各种距离。
RoPE 的实现:转一个角度
RoPE 的做法在代码里是把相邻的坐标两两配对,当成一个二维平面上的点,用 cos 和 sin 乘一下——这就是"旋转一个角度"的数学写法。
你不需要懂三角函数,只需要知道:把两个数用 cos 和 sin 各乘一遍再交叉相减相加,等于把这个点在平面上转了 val 弧度。
看代码前先介绍两个字母:表里会出现 Q 和 K,它们是注意力里每个词的两个身份。
Q 是"我在找什么",K 是"我有什么"****。
词回头看前面的词时,拿 Q 去提问,前面的词举着 K 当标签,问题和标签比对相似度。
这里可以先不着急理解,下一章会详细解释。
这里只需要知道:RoPE 转的就是这两个身份——谁找谁,取决于双方的相对位置。
var i: usize = 0;
while (i < dim) : (i += 2) {
    const head_dim: f32 = @floatFromInt(i % head_size);
    const freq = 1.0 / std.math.pow(f32, 10000.0, head_dim / (@as(f32, @floatFromInt(head_size))));
    const val: f32 = @as(f32, @floatFromInt(pos)) * freq;
    const fcr = std.math.cos(val);
    const fci = std.math.sin(val);
    const rotn: usize = if (i < kv_dim) 2 else 1; // 先不管
    for (0..rotn) |v| {
        const vec = if (v == 0) s.q else s.k; // the vector to rotate (query or key)
        const v0 = vec[i];
        const v1 = vec[i + 1];
        vec[i] = v0 * fcr - v1 * fci;
        vec[i + 1] = v0 * fci + v1 * fcr;
****** 第一步:遍历144根坐标对**
****** 第二步:这根针该多快?查"位数表"**
i % head_size就是维度的:编号 0 = 个位(快),编号 46 = 高位(慢)。
8 个 head 用同一张转速表,所以第 48 维(下一个 head 的第 0 维)又回到最快。
这里冒出一个词:head(“head 有 48 维”)。
head 就是**“回头看”这个动作同时做几遍。**
一个词和前面的词同时存在好几种关系:“它"指代谁、动词的主语是谁、哪个词离我最近。
只有一套提问方式的话,这些关系会被压成一个分数,互相稀释。
分成 6 个 head,就是允许同时问 6 种问题。
切法很朴素:288 维剪成 6 段,每段 48 维。
每个 head 只拿自己那一段,独立算一遍"谁该看谁”,得出自己的一份权重;6 份结果再拼回 288 维,交给下一层。
不是复制 6 份坐标,是把一份坐标切成 6 个窗口。
类比:一篇稿子过 6 个校对,一个盯语法、一个查人名一致、一个数距离,每人一个分,叠起来才盖全。
分工不是人定的:6 个 head 起点都是随机数,训练后各自擅长某类关系,是自发长出来的。
模型文件头实测:n_heads=6,每 head 48 维。RoPE 转速表按 48 取余,正是一个 head 配一套完整的快慢针——6 张时钟图一模一样。head 具体怎么"看",是下一章的主角。
****** 第三步:该转多少度?位置 × 转速**
站在第 2 位、转速 1.0 的快针:转 2 弧度(114°)。转速 0.000147 的慢针:转 0.0003 弧度——纹丝不动。和时钟图完全一致。
****** 第四步:cos/sin 是旋转的两个"配料"**
****** 第五步:这才是真正的"转"**
每组坐标过一遍“体检”
坐标从查表出来之后,在进入每一层的计算之前,要经过一个叫 rmsnorm 的步骤。
它的作用很朴素:把每组数字的大小拉回统一尺度。
原始坐标里,有的词天生数字大,有的词天生数字小。
" he" 长约 0.027、" she" 0.025、" moon" 0.023(常见词,被训练"磨短"了)
“今” 0.047、<unk> 0.047(英语童话语料里从没出现的行,长度分毫未动,和 <unk> 一模一样)
抽样 2000 行:全表最长约为最短的 2.9 倍
不管它们直接往下算,长箭头就"嗓门大"——点积与长度成正比。
它在后面的乘法加法里占更多权重,不是因为更重要,只是因为更长。
rmsnorm 把所有箭头缩到差不多长,只留方向、削掉长度 —— 意思在方向里,长度只是白占的音量。
**rmsnorm **代码看着很复杂,但它做的事可以用一个公式说清:
每个数字除以"全体数字的均方根"(就是你把所有数字平方、求平均、再开方——衡量这组数整体有多大),再乘一个可学习的缩放系数。
分母里加了一个极小的数(0.00001),防的是一种边界情况:如果一组数字全都是零(训练初期可能发生),分母变成零,除法会出错。
for (0..config.n_layers) |l| {
    // attention rmsnorm
    rmsnorm(s.xb, x, w.rms_att_weight[l * dim ..][0..dim]);


fn rmsnorm(o: []f32, x: []f32, w: []f32) void {
    assert(o.len == x.len);
    assert(o.len == w.len);

    const vector_width = DEFAULT_VECTOR_WIDTH;
    const vector_len = x.len / vector_width;
    const remainder_start = vector_len * vector_width;

    // sum of squares
    var vector_sum: @Vector(vector_width, f32) = @splat(0.0);
    var offset: usize = 0;
    for (0..vector_len) |_| {
        const values: @Vector(vector_width, f32) = x[offset..][0..vector_width].*;
        vector_sum += values * values;
        offset += vector_width;
    }
    var sum = @reduce(.Add, vector_sum);
    for (x[remainder_start..]) |val| {
        sum += val * val;
    }
    sum /= @floatFromInt(x.len);
    sum += 1e-5;
    sum = 1.0 / std.math.sqrt(sum);

    // normalize and scale
    const scale: @Vector(vector_width, f32) = @splat(sum);
    offset = 0;
    for (0..vector_len) |_| {
        const values: @Vector(vector_width, f32) = x[offset..][0..vector_width].*;
        const weights: @Vector(vector_width, f32) = w[offset..][0..vector_width].*;
        o[offset..][0..vector_width].* = values * scale * weights;
        offset += vector_width;
    }
    for (remainder_start..o.len) |i| {
        o[i] = x[i] * sum * w[i];
    }
}
残差:把原话抄一份带下去
上一节的体检,在进入每一层之前做
这一层到底干什么?模型最外层的循环跑 6 遍,每遍做两种加工:注意力(词互相看,决定该参考谁)和前馈网络(每个词自己消化加工)。
两者都是下一章的主角,这里只要记住它们是"每层对坐标做的变换"。
问题来了:如果每层都只保留变换结果,最初的词义会被一层层稀释——就像传话游戏,传了六轮之后原话已经面目全非。
解决方法叫残差连接(“残差"就是"剩下的、没被加工过的那部分”):
每一层把输入原样抄一份,加到输出上。用公式说就是 新坐标 = 旧坐标 + 这一层的加工结果。
残差的妙处在于它把"保留原样"变成了默认操作。
每层只需要学习"要加什么上去",不需要学习"哪些东西要保留" —— 因为保留是自动的。
这让训练稳定得多,也让模型可以堆更多层而不崩溃。
原文里有三处残差相关的代码(查表赋值和两次 accum 调用),纯赋值不值得占篇幅,改成一句话:每层做完变换,都把变换前的坐标加回去。
每层 transformer 的末尾把注意力和 FFN 后面的输出加回输入:
        // final matmul to get the output of attention
        matmul(s.xb2, s.xb, w.wo[l * dim * dim ..][0 .. dim * dim]);

        // residual connection back into x
        accum(x, s.xb2);

        // ffn rmsnorm
        rmsnorm(s.xb, x, w.rms_ffn_weight[l * dim ..][0..dim]);

        // Now for FFN in PyTorch we have: self.w2(F.silu(self.w1(x)) * self.w3(x))
        // first calculate self.w1(x) and self.w3(x)
        // matmul(s.hb, s.xb, w.w1[l * dim * hidden_dim ..][0 .. dim * hidden_dim]);
        // matmul(s.hb2, s.xb, w.w3[l * dim * hidden_dim ..][0 .. dim * hidden_dim]);
        // fused version of the above
        matmul_fused(2, [_][]f32{ s.hb, s.hb2 }, s.xb, [_][]f32{
            w.w1[l * dim * hidden_dim ..][0 .. dim * hidden_dim],
            w.w3[l * dim * hidden_dim ..][0 .. dim * hidden_dim],
        });

        // F.silu; silu(x)=x*σ(x),where σ(x) is the logistic sigmoid
        for (s.hb) |*v| {
            v.* = v.* * (1.0 / (1.0 + std.math.exp(-v.*)));
        }

        // elementwise multiply with w3(x)
        vector_mul(s.hb, s.hb2);

        // final matmul to get the output of FFN
        matmul(s.xb, s.hb, w.w2[l * dim * hidden_dim ..][0 .. hidden_dim * dim]);

        // residual connection
        accum(x, s.xb);
fn accum(a: []f32, b: []f32) void {
    assert(a.len == b.len);
    for (0..a.len) |i| {
        a[i] += b[i];
    }
}
所以“残差连接”听着很高大上,其实就是5行代码。这个世界本没有什么谜题,黑话说多了就有了谜题。
进出共用一张表
最后跑完六层(后文介绍)转换后,x 已经是"意图向量"—— 讲移动坐标时提过它,要拿去给 32,000 个词打分。打分怎么算也讲过:与每一行做点积。
所以输出端需要一张 32,000 行 × 288 列的矩阵。
模型输入端用 embedding 表把编号变成坐标;
输出端要把 288 维坐标变回"32000 个词各得多少分"(每个候选词一个分数,这叫 logits)。
直觉上你可能会以为需要一张全新的 32000 × 288 的大表做输出投影。
实际上不需要。代码里最后一行的打分矩阵 wcls(输出端的分类权重)直接指向 embedding 表的同一块数据:
rmsnorm(x, x, w.rms_final_weight[0..dim]);

// classify into logits
matmul(s.logits, x, w.wcls[0 .. dim * config.vocab_size]);
这张 32,000 × 288 的 wcls 不是新表。加载模型时,它直接指向输入端查字典用的那张 embedding 表:
weights.wcls = if (shared_weights) weights.token_embedding_table else ptr;
// shared_weights 是什么:一个布尔值,回答"输出打分表 wcls 是不是和字典表同一张"。
为什么能共用一张表?
- 因为形式上刚好
输入端要的是"给每个词一个参照物",输出端要的也是"给每个词一个参照物"。
同一样东西,两个方向读。
- 语义上匹配
两个角色回答的是同一个问题:“这个词是什么意思?” 词义只有一份,读写共用。
代价是一个向量戴两顶一样的帽子。
帽子一(读的时候): " he" 那一行 288 个数是它作为输入的坐标——职责是"我出现在句子里时,帮模型预测下一个词"。一个好员工的标准:让下游算得准。
帽子二(写的时候): 还是那一行,作为输出时的职责变了——“当正确答案是我时,要让意图向量容易指向我”。好员工的标准:让自己被认出来。
模型大到不在乎多一张表时,才让两个角色各戴各的帽子:
Llama-2 全系、Qwen2.5 7B 以上、DeepSeek-V3、Kimi K2,清一色不共用。
最小的 Qwen2.5-0.5B 才声明共用。
这个 15M 小模型没得选,参数预算容不下第二张大表。
那 32000 个分数接下来怎么变成概率、怎么抽签挑字,是下一章的主角。
词与词怎么互相看一眼
上一章结束时,每个词都有了一串带位置的坐标。
可坐标各自孤立—— “他"不知道"她"就在旁边。
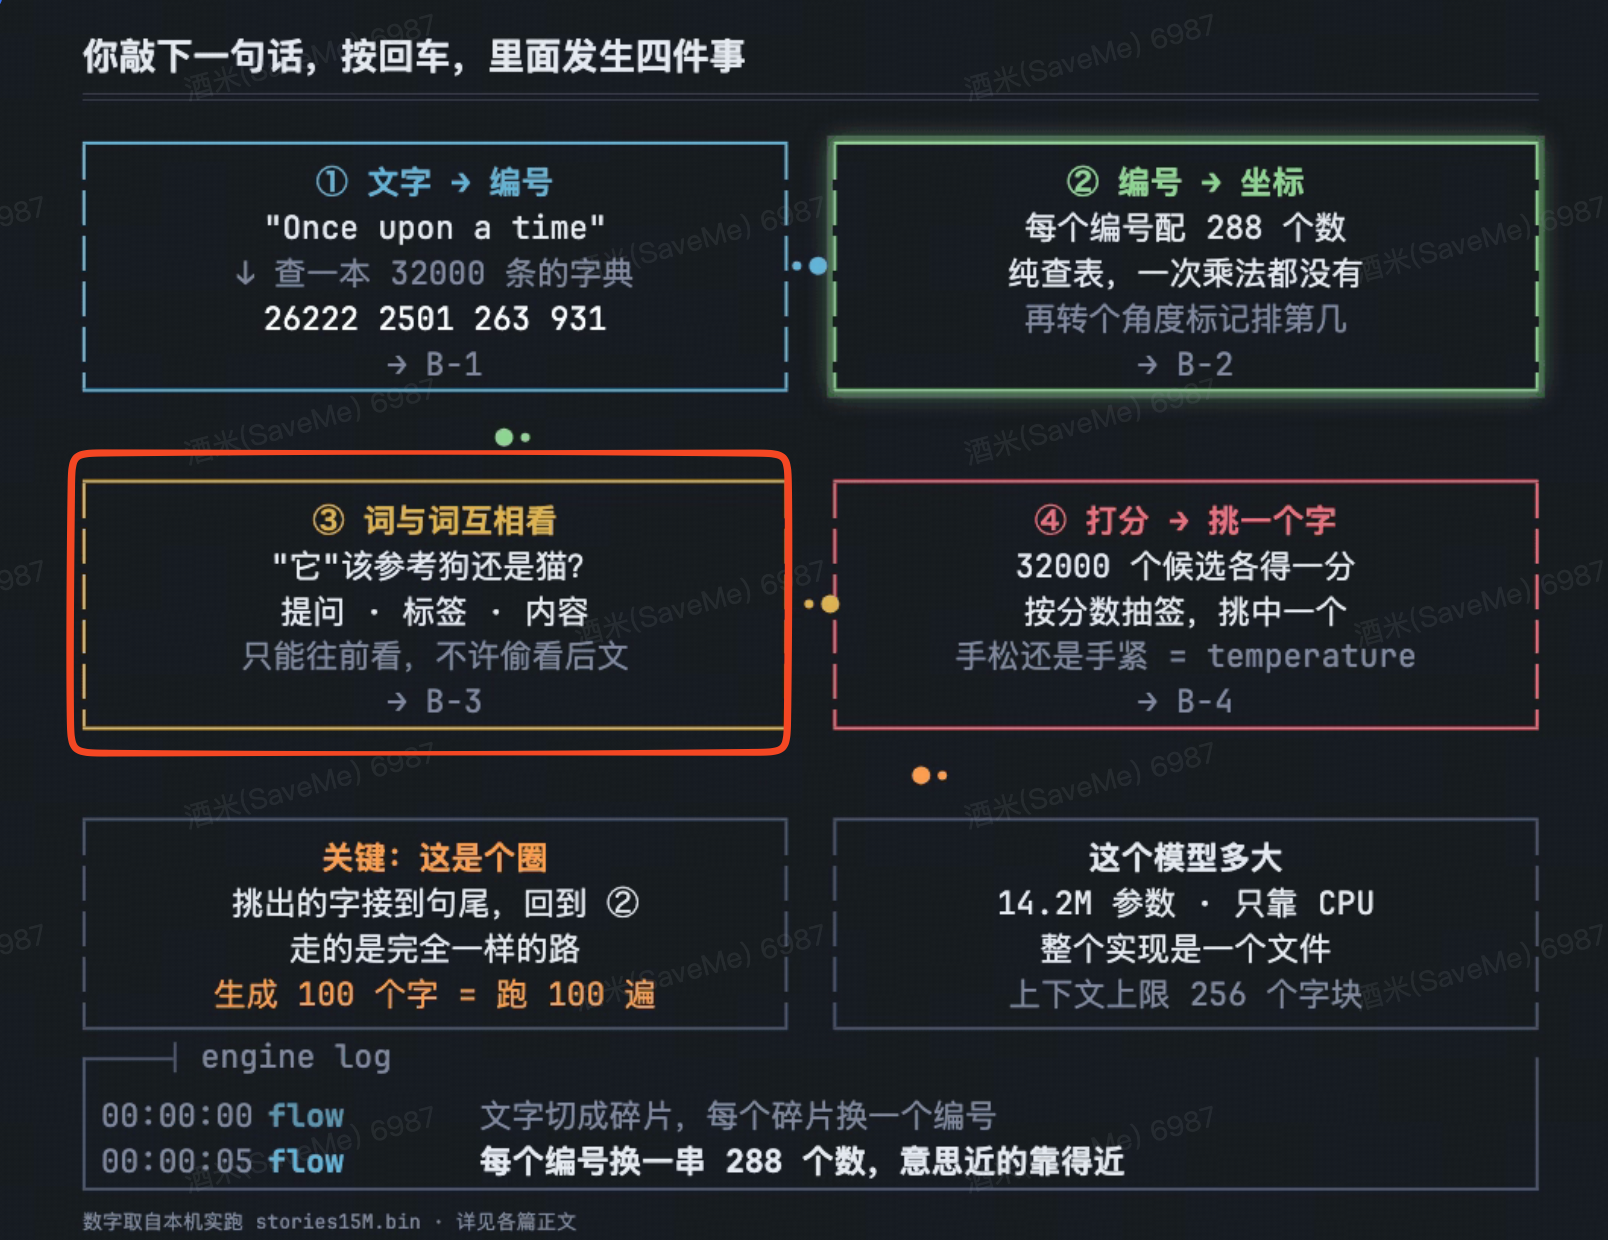
这一章走四道关口的第三道:互看一眼。
每个词回头去看前面的所有词,自己决定该重点参考谁。
这是全篇最核心的一章 —— 读完你应该能跟别人说清 Transformer 到底在干什么。
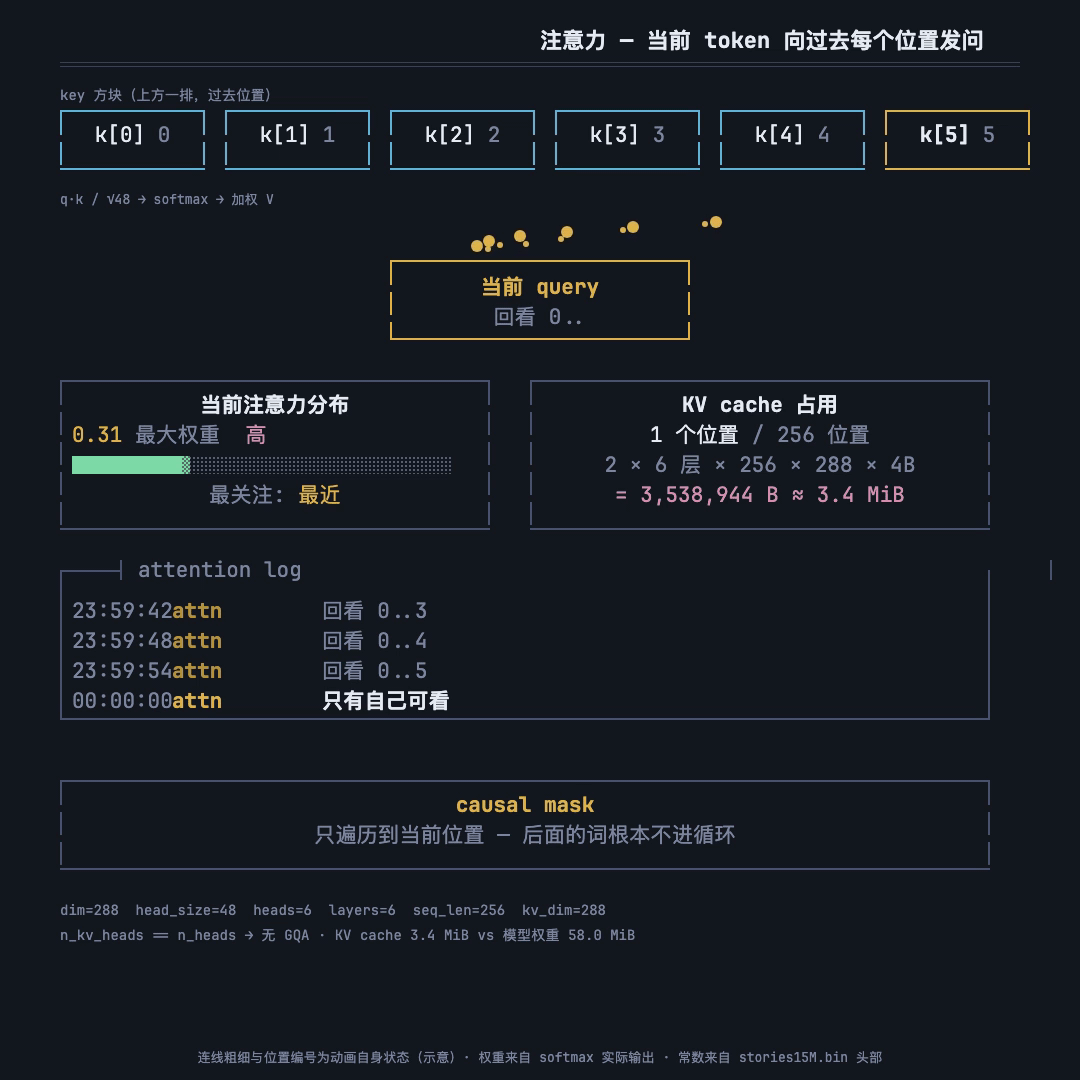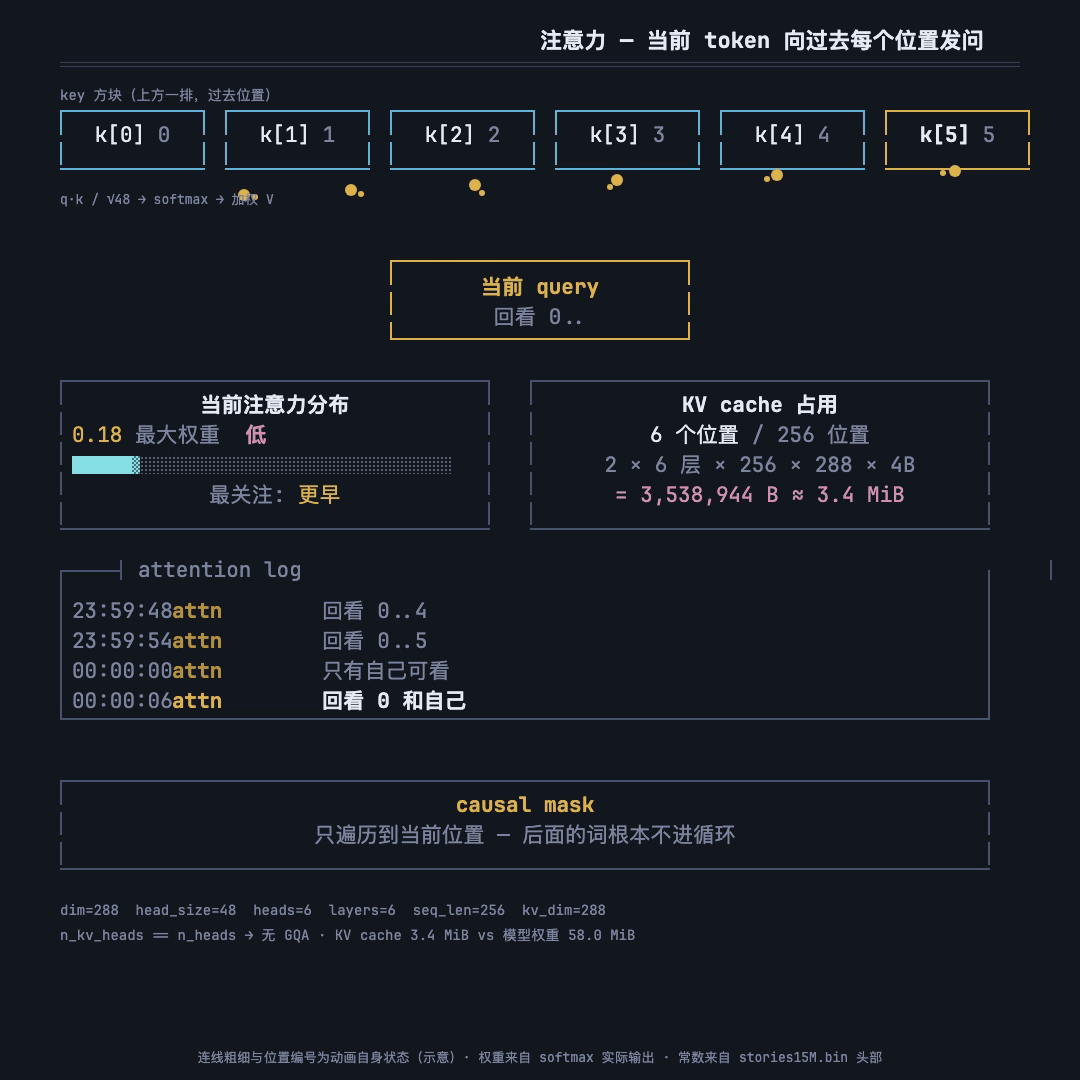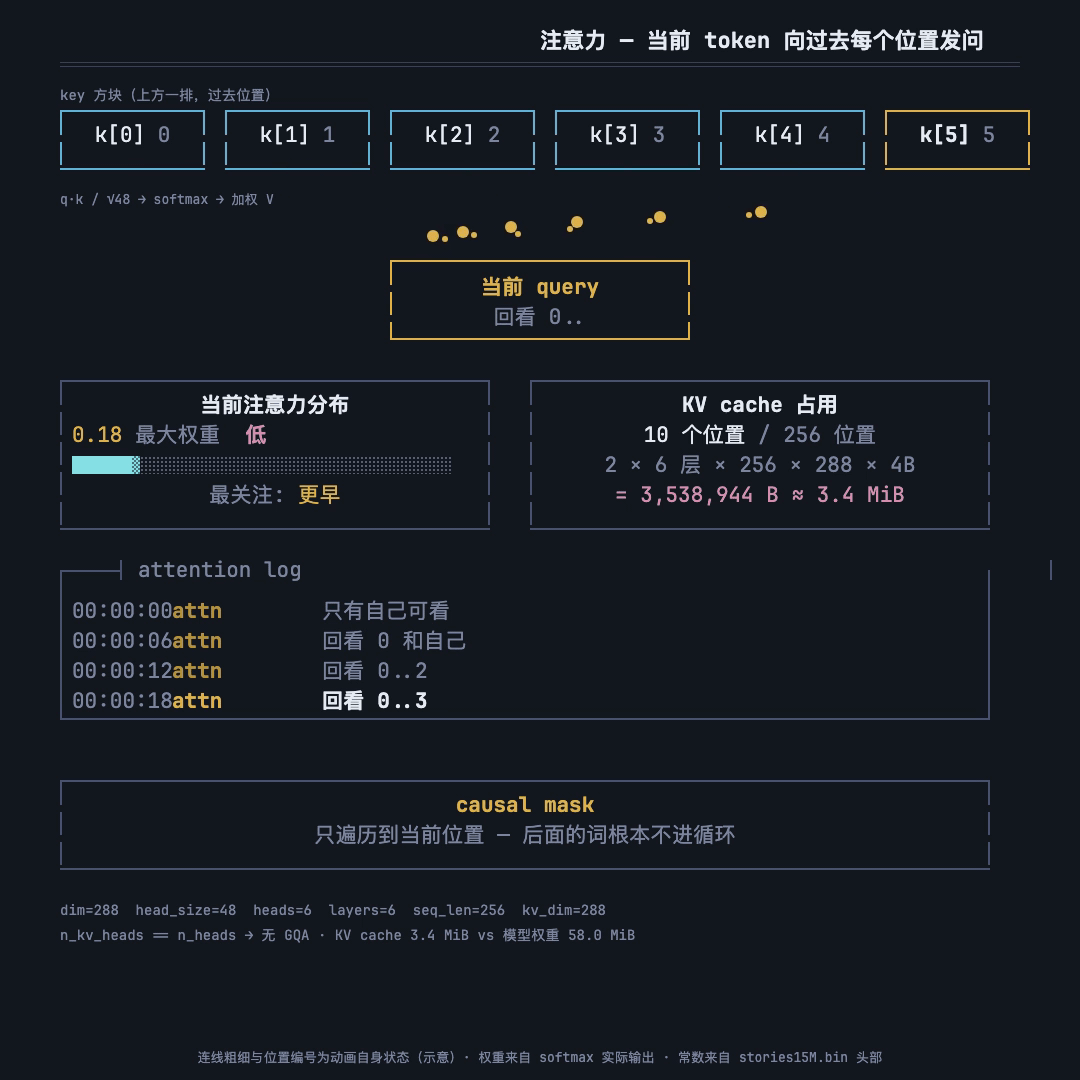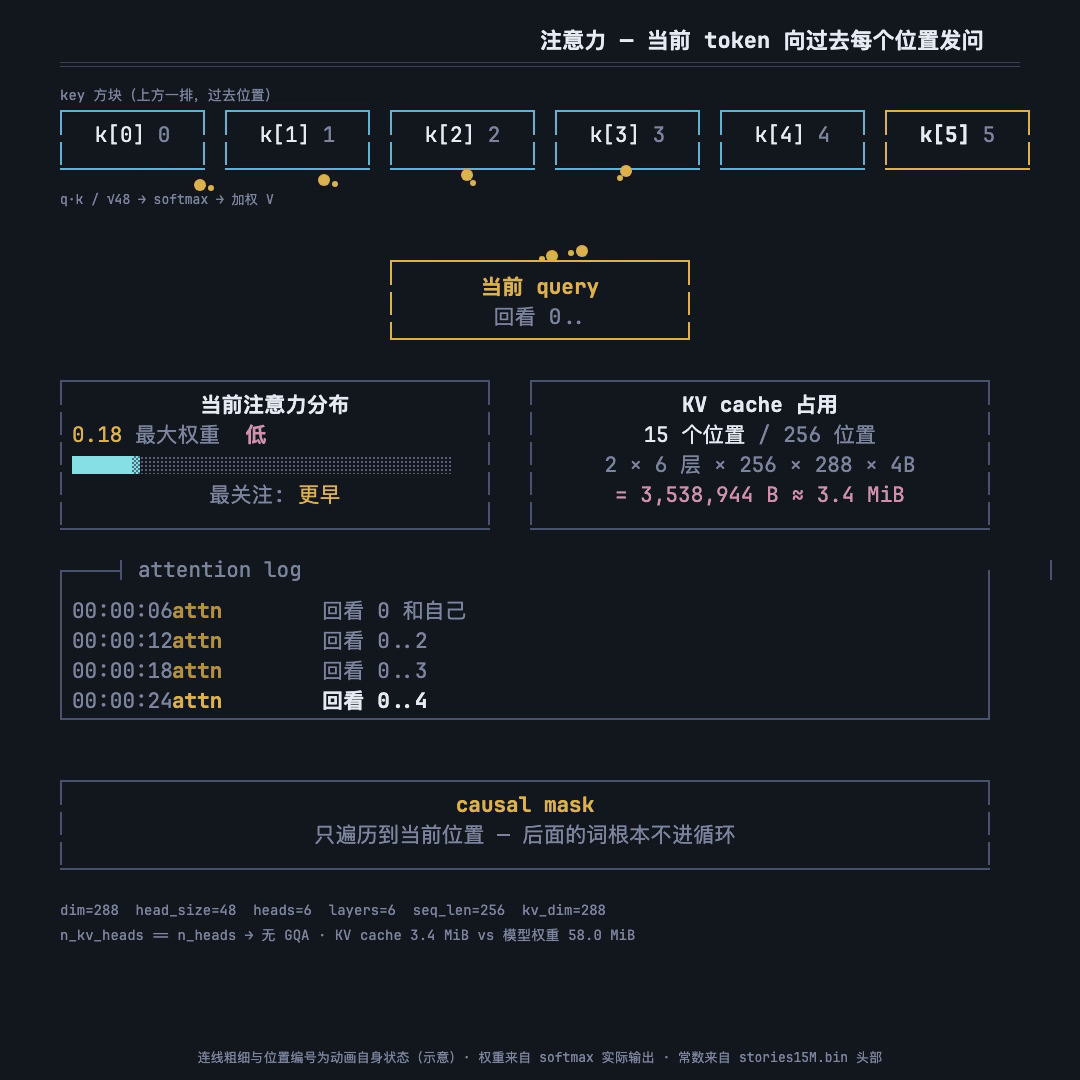
为什么需要看上下文
总览图左下那格黄色的,是四道关口的第三道:互看一眼。
看这句话:“小明养了一只狗,它很乖。”
“它"自己没什么含义。这两个字单独拿出来,你不知道它指狗还是猫。
含义来自它指向"狗” —— 但如果模型只看"它"旁边一两个词,还是分不清。
老式语言模型就是这么做的:只看邻近几个词。
看到"它很"就猜"乖”,看到"养了一只"就猜"狗",
但从来不会把"小明"和"它"连接起来。
注意力不一样。它让第 5 个词"它"直接看到第 1 到第 5 个词的所有信息,自己算出:“我该重点参考第 4 个词’狗’。“不需要分步传话,不需要信息逐词接力,一步到位,每个词都能看到前面所有的词。
这就是 Transformer 和老式模型的根本区别:注意力给了模型"回看任意远"的能力。
Q / K / V:图书馆找书
注意力怎么决定"该重点看谁”?
模型给每个词准备三份不同的坐标,想象你在图书馆找书:
Query(Q)—— 你的提问:“我想找关于动物的书。”
Key(K)—— 书的标签:“这是植物学"“这是动物百科"“这是烹饪”。
Value(V)—— 书的内容:你最终要读的东西。
你拿着提问(Q),去和每本书的标签(K)比对。
标签越合你意的那本书,你引用它的比例越高。
最后你按照引用比例,把几本书的正文(V)按比例混在一起读 —— 这就是注意力。
关键:Q、K、V 都不是从天而降的。
它们是同一个词的坐标分别乘三张不同的对照表得来的。
为什么要三张不同的表?因为"提问"和"标签"的功能完全不同。
提问关心的是"我想找什么”——它偏向"动物"“宠物"这类概念。
标签关心的是"我能被怎么找到”——“狗"这个词的标签要同时覆盖"动物"“宠物"“忠诚"等多个角度。
如果用同一张表生成 Q 和 K,那"狗"自己跟自己最像(点积最大),每次注意力都退化成"只看自己”。
三张独立的表让"提问"和"标签"各自学到不同的匹配策略,注意力才能真正找到"语义相关但不完全相同"的词 ——比如"它"和"狗”。
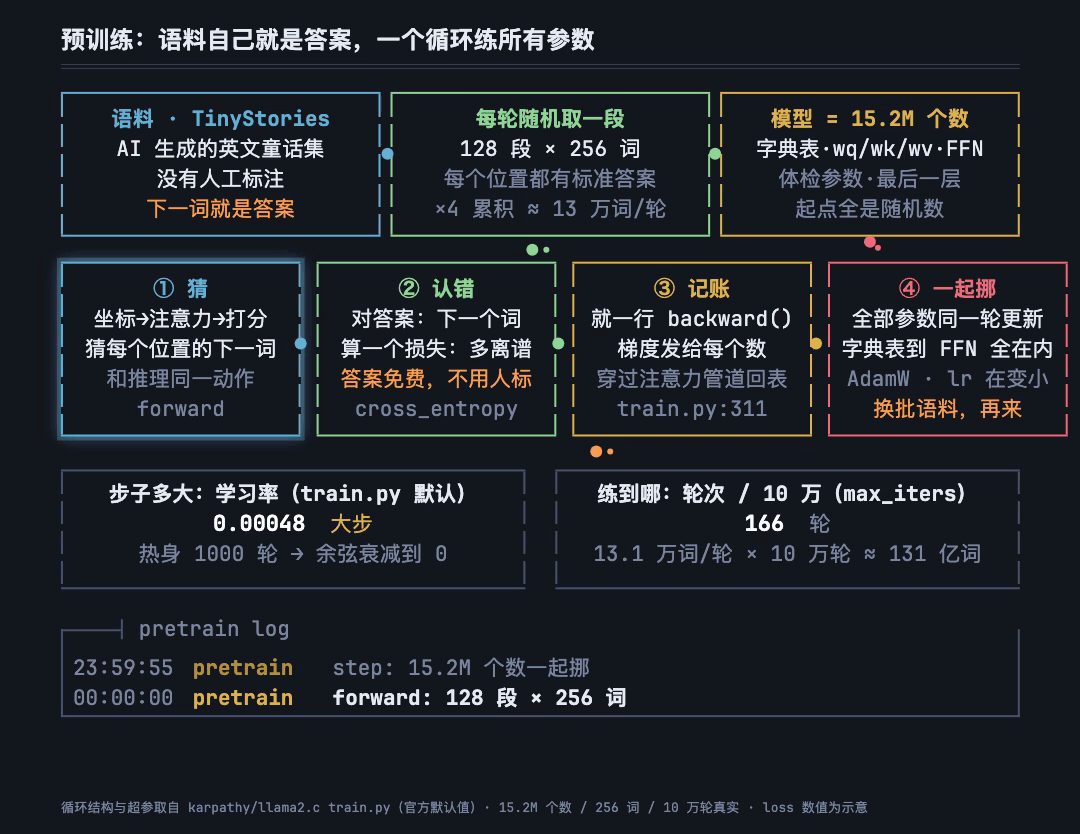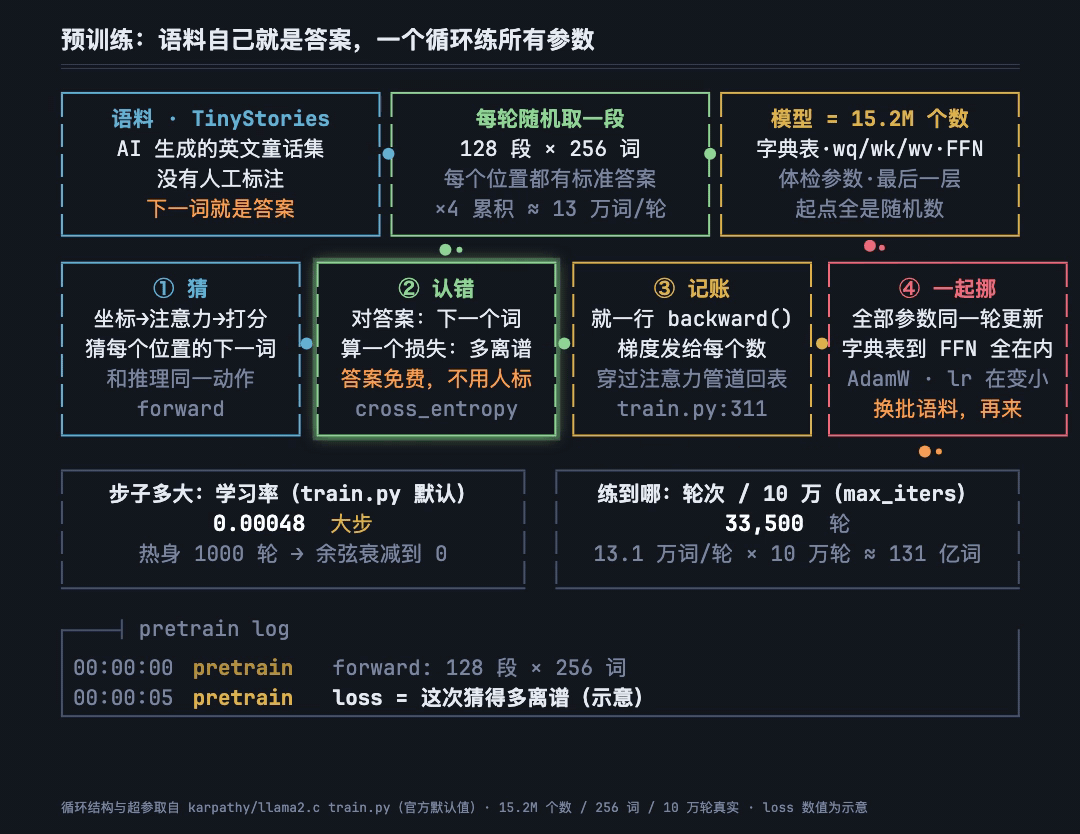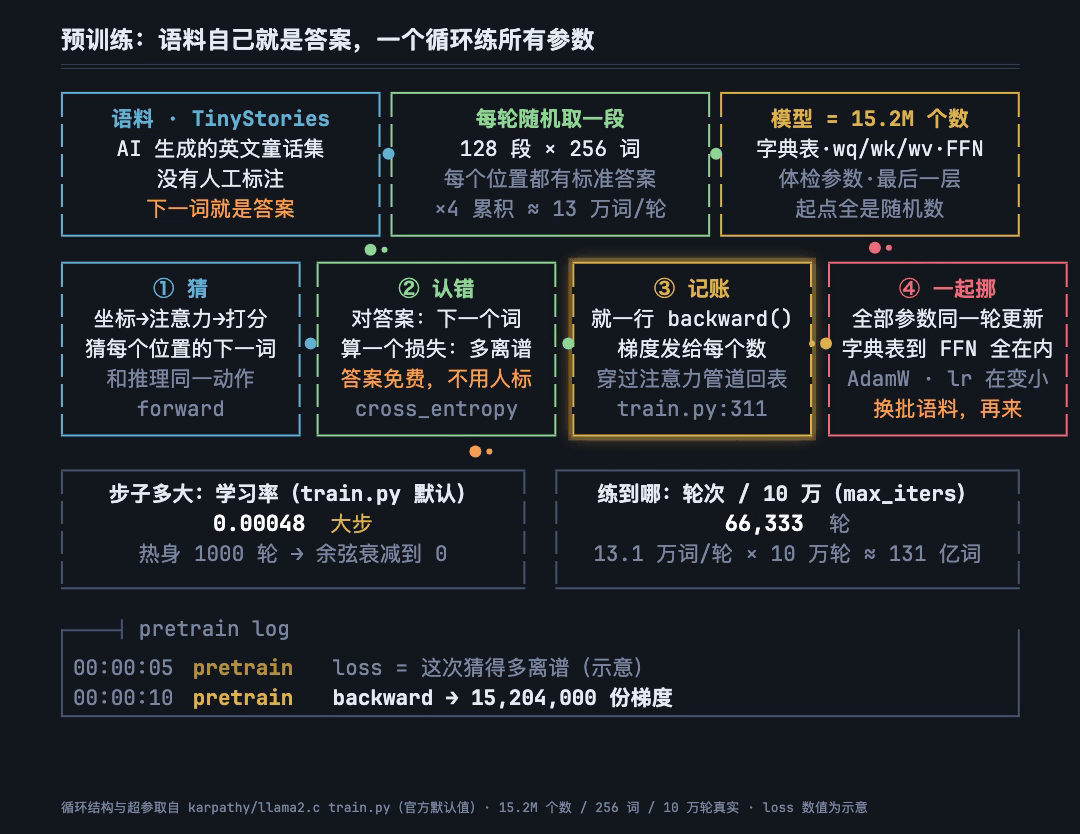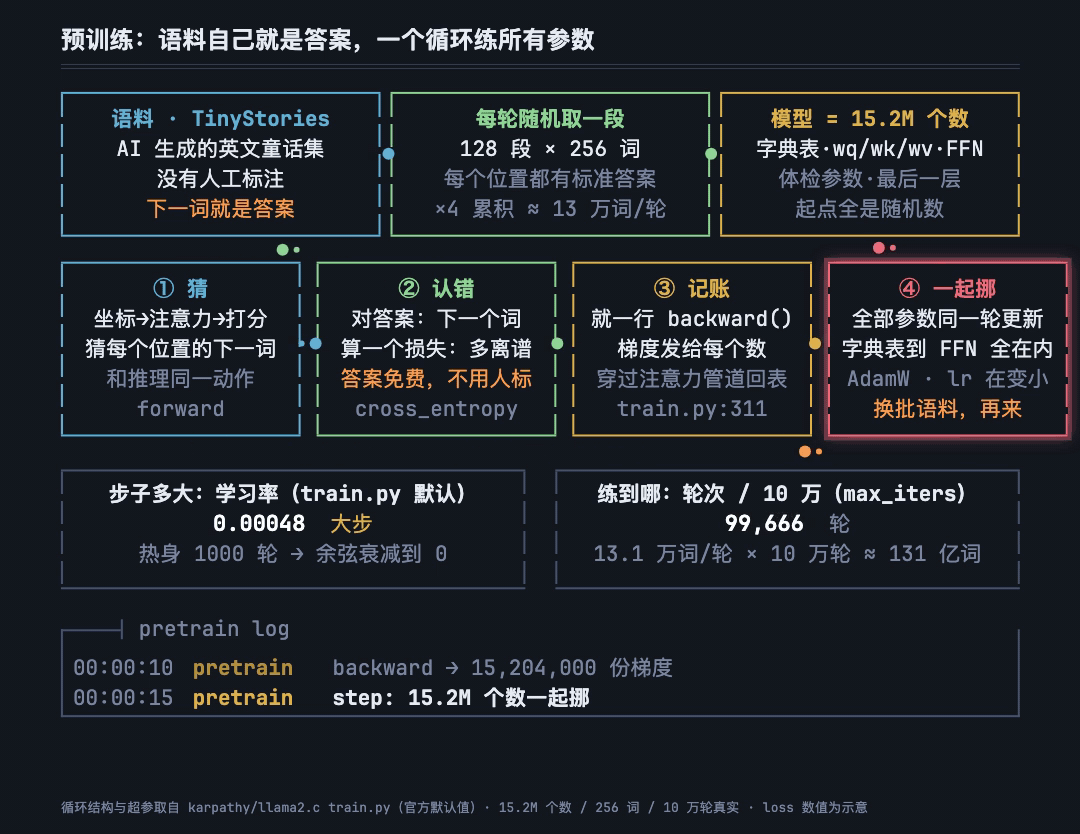
三张表是怎么练成的?
起点是一堆随机数(正态分布,model.py:243)。
它们走的就是 B-2 那套四拍循环:猜、认错、记账、挪一小步。
这个过程就是大家经常在网上听到的“预训练”过程。
标准的模型训练是三段式:
预训练(上述循环)→ SFT(人写的问答对继续用同一套循环练)→ RLHF(人类给回答排序、训一个奖
励模型再调)。
后两段统称 post-training (后训练)——循环机制一模一样,变的只是"标准答案从哪来”(语料自带 → 人写的 → 人类偏好)。
stories15M.bin 就是拿 TinyStories 童话集按这三条从零练出来的,没有后训练过程。
llama2.zig 连 SFT 都没有,它就是个预训练完的裸模型,所以你问它"天气"它会像续写小说一样接话,而不是像 ChatGPT 那样回答。
计算QKV的代码如下:
matmul_fused(3, [_][]f32{ s.q, s.k, s.v }, s.xb, [_][]f32{
    w.wq[l * dim * dim ..][0 .. dim * dim],
    w.wk[l * dim * kv_dim ..][0 .. dim * kv_dim],
    w.wv[l * dim * kv_dim ..][0 .. dim * kv_dim],
});
“乘一张表"是什么意思?
做个 3 维迷你版 —— 坐标只有 3 个数、表只有 3 行。每一行是一个混合配方:
坐标 xb = [0.2, -0.1, 0.5]

wq 第 1 行 [1.0, 0.0, 0.0] → 0.2×1.0             = 0.20  只听第 1 维
wq 第 2 行 [0.0, 0.0, 1.0] → 0.5×1.0             = 0.50  只听第 3 维
wq 第 3 行 [0.5, 0.5, 0.0] → 0.2×0.5 − 0.1×0.5   = 0.05  第 1、2 维各取一半

输出 q = [0.20, 0.50, 0.05]
输出的每个数 = 坐标与表的一行逐位相乘、全部加起来。
真实版只是变大:表 288 行,输出 288 个数。每行配方把 288 个维度全混一遍,系数是一堆学出来的小数。
“提问"能问出多抽象的问题,取决于这些配方混得多巧。
三张表、三套配方、三个输出,输入是同一份:
┌ × wq 提问配方 → q  "我想找什么"
xb(288 个数)─┼ × wk 标签配方 → k  "我有什么标签"
              └ × wv 内容配方 → v  "我能提供什么"
matmul_fused(3, …) 里的 3,意思是"三论计算捆一起做”。
纯粹是为了性能:xb 从内存读一遍,不是三遍。
点积打分:怎么判断像不像
有了 Q 和 K,下一步是给每个候选词打分。
打分方法是点积——把两个 48 个数的列表,对应位置相乘再加起来。
为什么是 48 不是 288?因为打分按 head 分头进行。
上一章说过:288 维剪成 6 段,每段 48 个数,每个 head 只看自己那段——所以一次点积只乘 48 对数
结果越大,说明这两个向量方向越接近,也就是"越相关”。
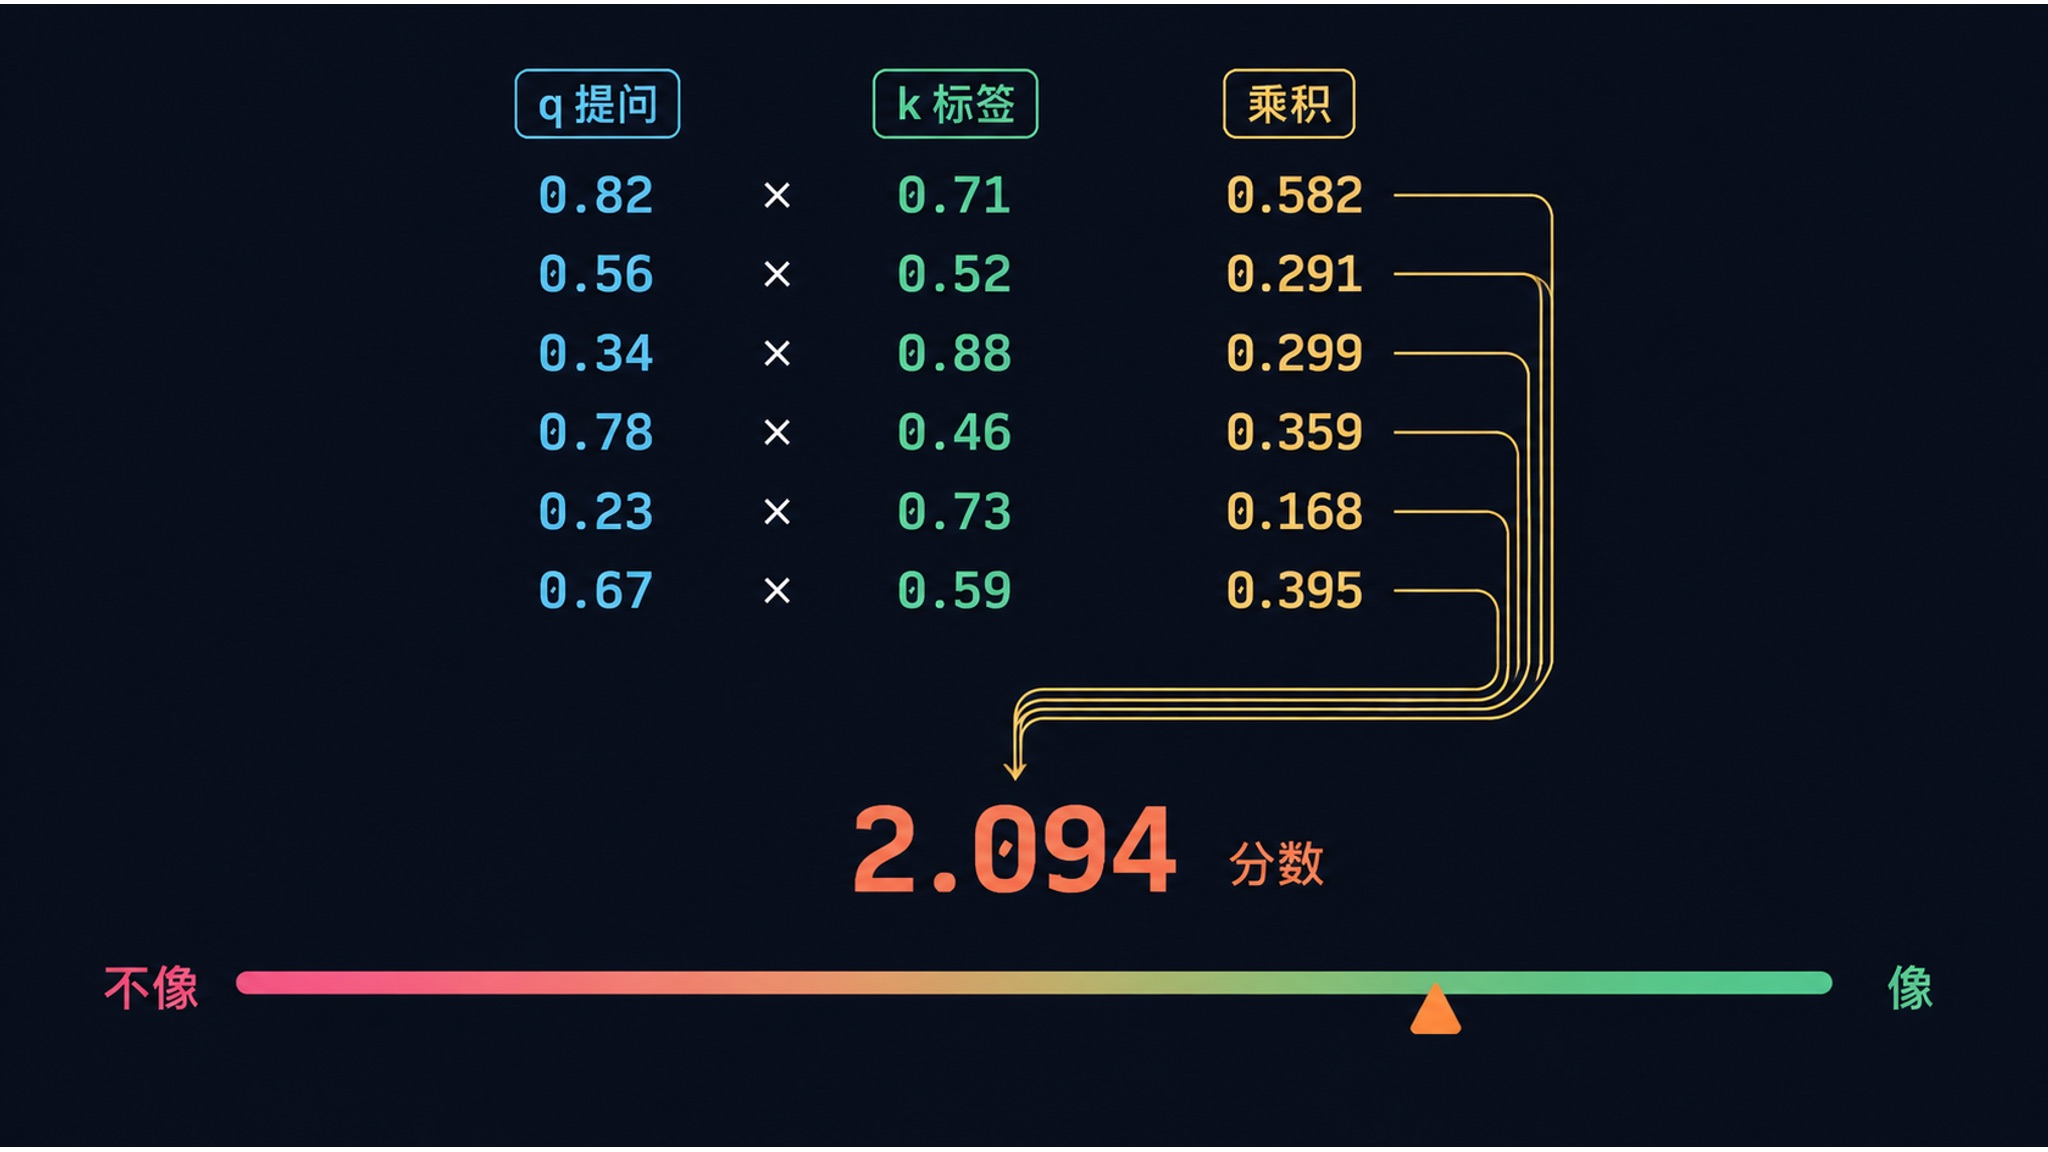
举个例子:两个人的兴趣列表 —— 小明喜欢动物、户外、音乐;小红喜欢动物、阅读、音乐。
把他们的兴趣按顺序对齐,相同的项乘积大,加起来总分就高。
点积就是"像不像"的量化。
为什么不用"逐个比对是否相同"来打分?因为词的含义不是"相同"或"不同"这么简单。
“它"跟"狗"不是同一个词,但它们在语义上有关联。
点积可以捕捉这种渐进的相关性:完全相同得高分,有些相似得中等分,完全无关得低分甚至负分。
这种连续的打分方式让 softmax 能给所有词分配不同比例的注意力,而不是简单粗暴地"选一个”。
但维度高了之后有个问题:48 个乘积加起来,随机波动比只有 2 个数大得多。
如果不管这个波动,分数可能很大也可能很小,后面 softmax 会变得极端(几乎只选一个词)。
所以要把分数除以 √48 —— 让分数的波动幅度跟维度无关。
causal mask:只能往前看
每个词只能看到它前面的词,不能看到它后面的。
这不是技术限制,是设计要求。
训练时,模型要做的事是"给你前面的词,猜下一个词”。
如果模型在猜"乖"的时候偷看了"乖”,那就等于把答案抄了。
所以生成和训练都必须屏蔽未来。
在代码里,屏蔽未来的全部实现就是循环上界:
// attention
for (0..config.n_heads) |h| {
    // get the query vector for this head
    const q = s.q[h * head_size ..][0..head_size];
    // attention scores
    const att = s.att[h * config.seq_len ..][0..config.seq_len];
    // iterate over the timesteps, including the current one
    for (0..pos + 1) |t| {
        // get the key for this timestep
        const k = s.key_cache[loff + t * kv_dim + (h / kv_mul) * head_size ..][0..head_size];
        // attn score as the dot of q and k
        var score: f32 = vector_dot_product(q, k);
        score /= std.math.sqrt(@as(f32, @floatFromInt(head_size)));
        // save the score
        att[t] = score;
    }

    // softmax the scores to get the attention weights for 0..pos inclusive
    softmax(att[0 .. pos + 1]);

    // weighted sum of the value vectors store back into xb
    const xb = s.xb[h * head_size ..][0..head_size];
    const value_head_offset = (h / kv_mul) * head_size;
    vector_weighted_sum_rows(
        xb,
        s.value_cache[loff + value_head_offset ..],
        kv_dim,
        att[0 .. pos + 1],
    );
}
蓝色代码块: 分成 6 个 head 各看各的
橙色代码块:准备好两个东西
本 head 的q:48 个数
本 head 的成绩单:256 个格子
q 是从 288 个数的提问向量里剪下第 h 段。
att 是一张空白成绩单—— 将来 “第 0 位多少分、第 1 位多少分……” 逐格填进去。
红色代码块:内层循环 = 挨个给前面的位置打分
这几行正好是「点积打分」的内容:取出第 t 个位置的标签 k → 与 q 做点积 → 除以 √48 → 填进成绩单第 t 格。
[0..pos + 1] 就是 causal mask 本尊。 循环只走到当前位置(含),后面的位置根本没被打分。
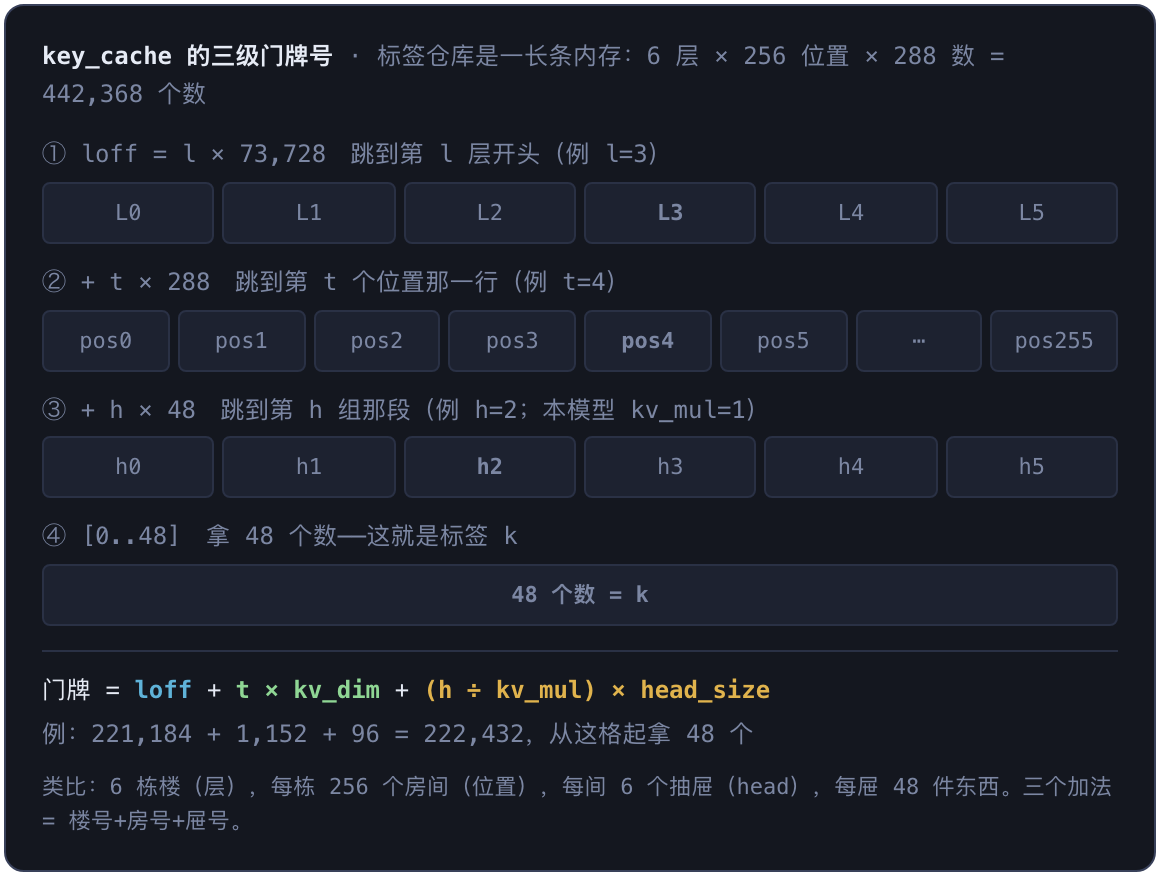
loff(layer offset)+t × kv_dim+**(h ÷ kv_mul) × head_size**** **
这串加法是"三级门牌号"机制。
k 藏在一个大缓存 key_cache 里(这就是 KV cache!)
地址 = loff(哪栋楼:第 l 层的起点)+ t * kv_dim(几零几:第 t 个位置一行有288 个数)+ (h / kv_mul) * head_size(哪个房间:本 head 的 48 个数)。
h / kv_mul 是给"几个 Q 头共享一份 K"的大模型留的换算,这模型 kv_mul=1,除完就是 h 本身。
在KV cache那一章会详细解释。
- 绿色代码块:softmax = 分数变权重
上一节聊的那道工序,原样出现在这:把"2.09、0.5、−0.8……“变成"62%、34%、3%……",总和 1。
注意切片长度还是 pos+1 —— 只归一化看得见的位置。
- 紫色代码块:按权重抄内容 = 注意力的产出
拿着权重单,把每个位置的内容向量 v(同样从 value_cache 按三级门牌号取)按比例混合:
输出 = 62%×v₀ + 34%×v₁ + 3%×v₂ + …。
结果 48 个数,写回 s.xb 的第 h 段。
这就是图书馆类比的最后一步:“按引用比例,把几本书的正文混在一起读”。
多头注意力:6 个不同兴趣的读者
为什么是 6 组注意力,而不是 1 组 288 维?
因为一组注意力只能表达一种"什么和什么相关"的关系。
6 组可以同时捕捉 6 种不同的关系——一个组可能关注语法搭配,另一个组关注"它"指的是谁,第三个组关注主语和谓语的搭配……
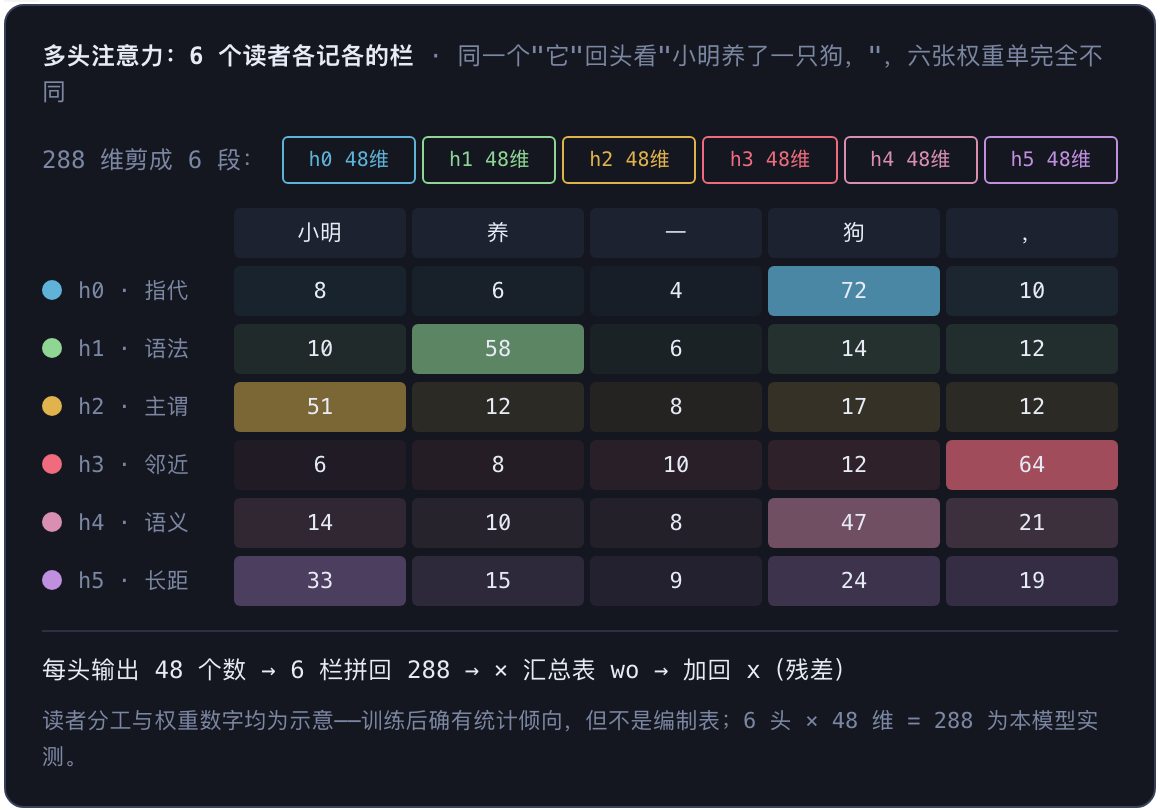
例如:让 6 个不同兴趣的读者同时读同一段话。
读者 A 关注语法,读者 B 关注指代,读者 C 关注语义……最后把 6 个人的笔记拼在一起。
每个读者只看 48 个数(288 ÷ 6 = 48),6 个人加起来还是 288——没有信息丢失,只是分工了。
每组独立完成"拿提问→比对标签→按概率混合内容"的完整流程。
最后 6 组的结果拼回 288 个数,继续下一层。
为什么恰好是 6?
先有硬约束:头数必须整除 288,5 头、7 头都不行,候选只有 4×72、6×48、8×36……
再有权衡:头太少只剩一种问题;头太多每头太瘦,配方混不出复杂信息,连 RoPE 的快慢针都铺不满。
换头数也不省参数 —— wq、wk、wv 不管怎么分都是 288×288,这是形状选择,不是花钱决定。
业界惯例是头宽近似恒定:Llama 3.1 405B 用 128 头、每头 128 维,模型大一倍就头数翻倍。
这个 15M 小模型的 6 头 × 48 来自同一张缩放表 —— 它不是自然常数,是一个约定的常数。
softmax:把分数变成概率
打完分,有了"像不像"的分数列表。
但分数不是概率 —— 可能是负数、可能加起来不等于 1。
softmax 做两件事:
把每个分数变成正数
让所有正数加起来等于 100%。
举个例子。假设 5 个候选词的分数是 2.0、1.0、0.5、−0.5、0.0:
| 原始分数 | 减最大值 | 取指数(e^x) | 归一化成概率 |
|---|---|---|---|
| 2.0 | 0.0 | 1.000000 | 55.2966% |
| 1.0 | −1.0 | 0.367879 | 20.3425% |
| 0.5 | −1.5 | 0.223130 | 12.3383% |
| −0.5 | −2.5 | 0.082085 | 4.5390% |
| 0.0 | −2.0 | 0.135335 | 7.4836% |
| 总和 1.80843 | 总和 100% |
结果加起来正好 100%。
概率最大的词(55.3%)会被重点参考,其他词也有一定份额 —— 注意力不是"只看最相关的那个词”,而是"按比例看所有前面的词"。
为什么要先减最大值?
因为指数函数 e^x 增长极快 —— e^90 已经大到计算机存不下。
如果分数里有很大的数,直接取指数会"数字大到装不下"。
先减去最大值,所有输入都变成负数或零,指数最大也只是 1,永远不会溢出。
代码里就是这一步:
fn softmax(x: []f32) void {
    assert(x.len > 0);
    // max of x for numerical stability
    var max: f32 = x[0];
    for (x[1..]) |val| {
        if (val > max) {
            max = val;
        }
    }
    // exp and sum
    var sum: f32 = 0.0;
    for (x) |*val| {
        val.* = std.math.exp(val.* - max);
        sum += val.*;
KV cache:为什么只存标签和内容
到这里,一次完整的"回头看"已经走完了:打分、softmax、按权重单抄内容。
还记得总览图里那个圈吗?
每次挑出的字接到句尾,下一个字又要回头看一遍。
生成 100 个字的句子,就要回头看 100 次,每次都是全套流程。
每次回头看,都要用到前面所有词的标签和内容。难道每次都重算一遍?
想象你在图书馆已经读完了前 200 本书,现在来了第 201 本书。
你要拿着它的提问,跟前面 200 本书的标签比对。
如果你每次都重新计算前面 200 本书各自的标签和内容,那就等于把前 200 本书从书架上取下来重新整理一遍。
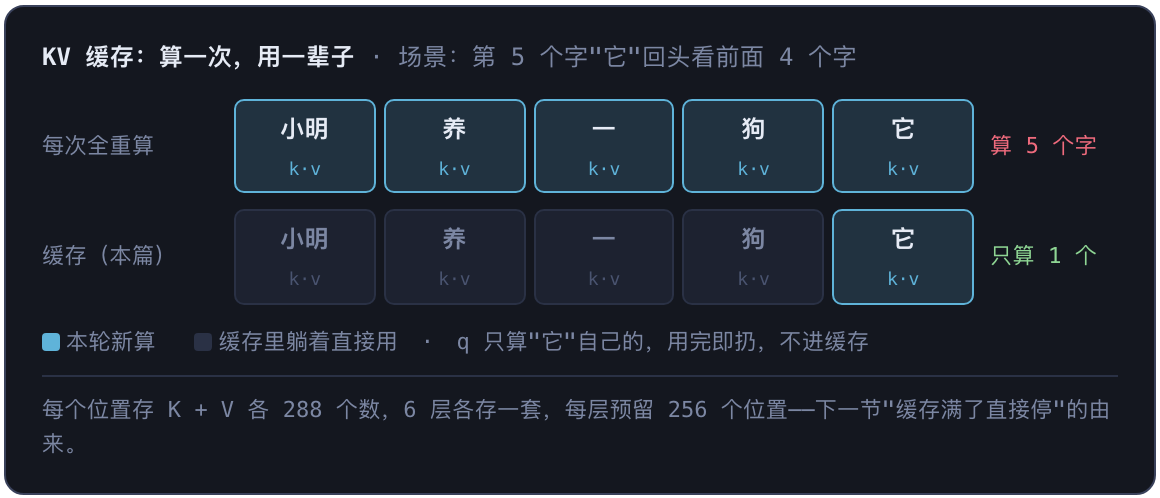
前面那些词的标签 K 和内容 V **不会变 **—— “狗"的标签始终是它自己的,不管后来来了多少新词。
所以一次算好,存下来,以后每次直接用。
而**提问(Q)**只有当前这一个词需要。
前面词的提问在它们当时被处理时已经用过了,现在不需要。
所以缓存省下的正是最占地方的那部分 —— 每个位置要存 K 和 V 各 288 个数。
写缓存的代码只有两行:
const loff = l * config.seq_len * kv_dim; // kv cache offset
const key_cache_row = s.key_cache[loff + pos * kv_dim ..][0..kv_dim];
const value_cache_row = s.value_cache[loff + pos * kv_dim ..][0..kv_dim];
@memcpy(key_cache_row, s.k);
@memcpy(value_cache_row, s.v);
const loff = l * config.seq_len * kv_dim
第 l 层(层就是"加工车间"的计数单位,后续章节会详细解释)缓存在内存里的起点。
| 变量 | 含义 | 本模型的值 | 门牌号类比 |
|---|---|---|---|
l | 当前层号,循环 0 到 5;每层权重不同,缓存也每层各存一套 | 0…5 | 几号楼 |
config.seq_len | 每层预留的位置数,就是上下文上限;一个位置站一个词 | 256 | 每栋几间房 |
kv_dim | 每个位置一行的宽度:dim × n_kv_heads ÷ n_heads,本模型不共享,约掉等于 dim(坐标维度) | 288 | 每间房多宽 |
const key_cache_row = s.key_cache[loff + pos * kv_dim ..][0..kv_dim];
const value_cache_row = s.value_cache[loff + pos * kv_dim ..][0..kv_dim];
key_cache/value_cache 的内存布局如下:
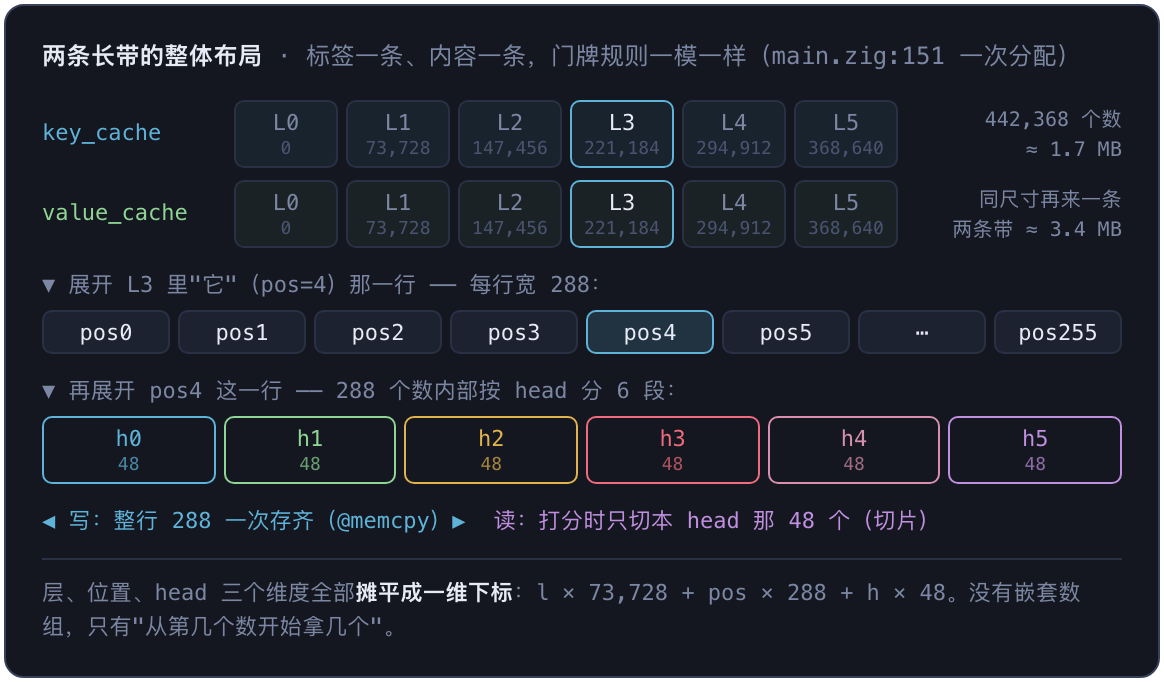
这行代码就是在key_cache中切割出填写cache的位置:
第一刀 [loff + pos * kv_dim ..]:“从这个编号开始,往后全算” —— 右边开口,只给了起点
第二刀 [0..kv_dim]:“从刚才的起点再拿 288 个” —— 定长截断
为什么缓存满了是直接停,而不是丢掉最早的词
上一节的图里说了,缓存是"按满栋盖房”:每层 256 间,pos 只增不减。
那么问题自然来了—— 写到第 256 间,句子还没完,怎么办?
两条路:丢掉最早的词,腾出房间继续写(有些推理系统就这么干);
或者干脆停,本篇选停。
下面四行代码就是全部答案:
seq_len = if (seq_len == 0) config.seq_len else seq_len;
seq_len = std.math.clamp(seq_len, 1, config.seq_len); // clamp to seq_len
var pos: usize = 0; // the current position in the sequence
while (pos < seq_len) : (pos += 1) {
这就是缓存存满的后果:模型不会优雅地丢弃最早的信息然后继续,它直接停止。
std.math.clamp 这行就是"不许超过 256"的全部执行。
没有别的。生成就停在那里。
clamp = 夹钳:不管传进来什么,一律夹进 [1, 256] 区间。
传 10000 → 夹成 256。
不许超过 256"这条法律的全部执法现场就是这一行——缓存只有 256 间房,生成请求在进门之前就被物理限制了。
这就是缓存存满的后果:模型不会优雅地丢弃最早的信息然后继续,它直接停止。
std.math.clamp 这行就是"不许超过 256"的全部执行。
其实"丢词续写"不是空想,工业界有两套成熟做法:
| 做法 | 代表 | 原理 | 出处 |
|---|---|---|---|
| 滑动窗口(训练时内建) | Mistral 7B、Gemma 2 27B | 每个词最多回看 4096 个位置,窗口外的老词本来就用不上 | Gemma 2 官方 config sliding_window: 4096 |
| 注意力汇聚(推理时补丁) | StreamingLLM | 永远保留开头几个词 + 最近窗口,只丢中间 | arXiv:2309.17453,ICLR 2024 |
KV cache 有多大? 代入真实常数:
KV 缓存 = 2(K+V) × 层数 × 上下文长度 × kv_dim × 每数字节
每层每个 token 存 K 和 V 各 288 个数,每个数 4 字节
6 层 × 2(K+V)× 288 个数 × 4 字节 = 每个token 13824 字节
256 个 token = 256 × 6 × 2 × 288 × 4 = 3,538,944 字节 ≈ 3.4 MiB
实测:后面的词不影响前面的判断
如果注意力遵守"只能往前看"的规则,那么位置 0,1,2 的判断不应该受位置 3,4,5 内容的影响。
用两个不同长度的 prompt 验证:
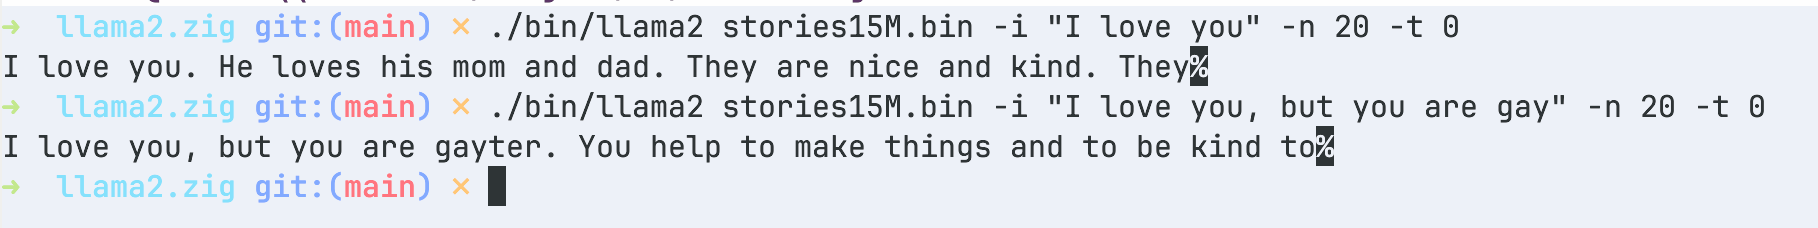
- -i 起点句: -i “I love you” 的意思是"给模型一个开头,让它往下编"。
模型不是从空白开始写的,你喂的这句话就是它"回头看"的前文。
**-n 20 总步数:**prompt 3 个 token 也占额度,实写 17 个。
-t 0 贪心解码 —— temperature(温度)控制"掷骰子的随机程度":
1.0(默认):完全按概率转盘选词 —— 90% 的词常中,10% 的词偶尔也冒出来,故事有惊喜也有胡话
0:不掷了,每轮永远拿概率最高的那个词。转盘换成"必拿最大",这叫贪心(greedy)解码
两条 prompt 的前三个词相同(“I love you”),但从第 4 个词开始不同。
若因果性成立,生成"I love you"之后的第一个新词应当相同:位置 0-3 的计算只依赖位置 0-3。
两条输出确实都以"I love you"开头。
但注意:更长的 prompt 从位置 4 开始已经不同,后面的生成自然分叉。
它证明的是:同一句内,靠前位置的判断不受靠后位置影响。
更严谨的做法是用同一 prompt 截断比较,或递增 -n 检查前缀稳定性:
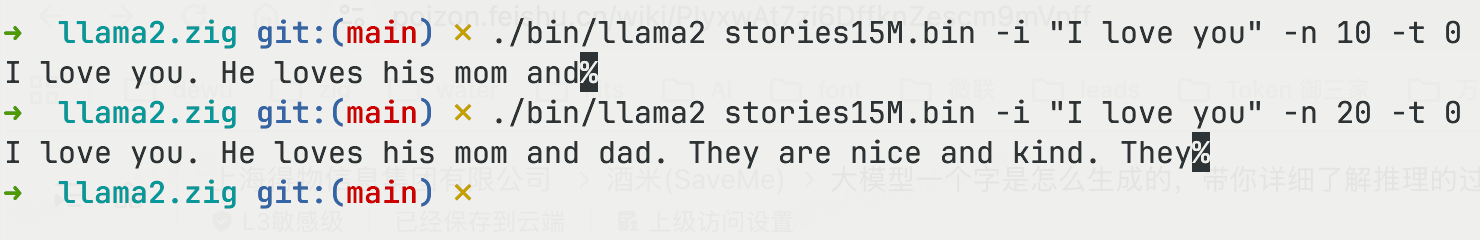
-n 10 时输出 “I love you. He loves his mom and”,-n 20 时的前 10 个词一模一样。
延长生成不改变已有前缀 —— 因为前面的判断已经"定型"了,新词只加在后面。
这就是因果性的实际表现。
从一堆分数里挑出下一个字
上一章停在 “它” 刚通过回头看知道自己指的是 “狗”。
可这份理解仍然锁在 288 个数里—— 模型的脑子里从头到尾没有"字"这个概念,它只有数和分数。
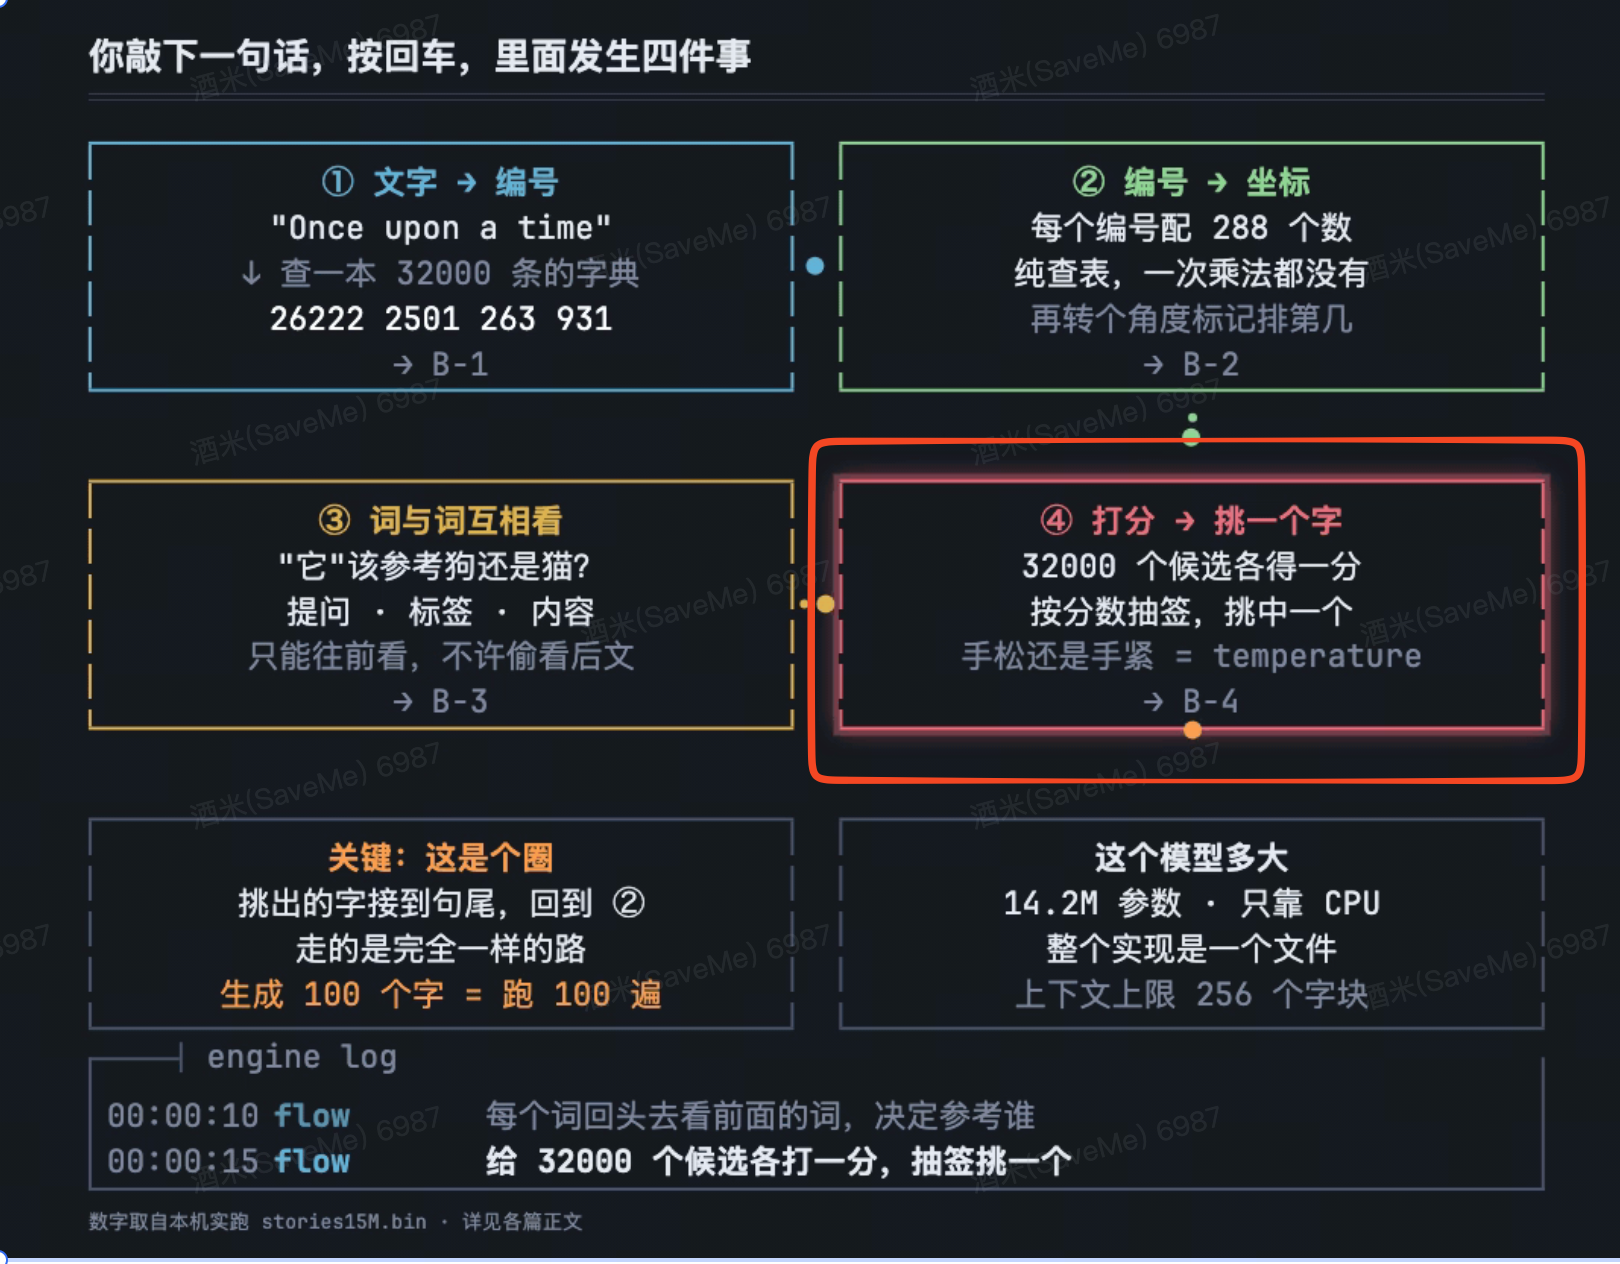
总览图右下那格红色的,是四道关口的第四道:打分挑字。
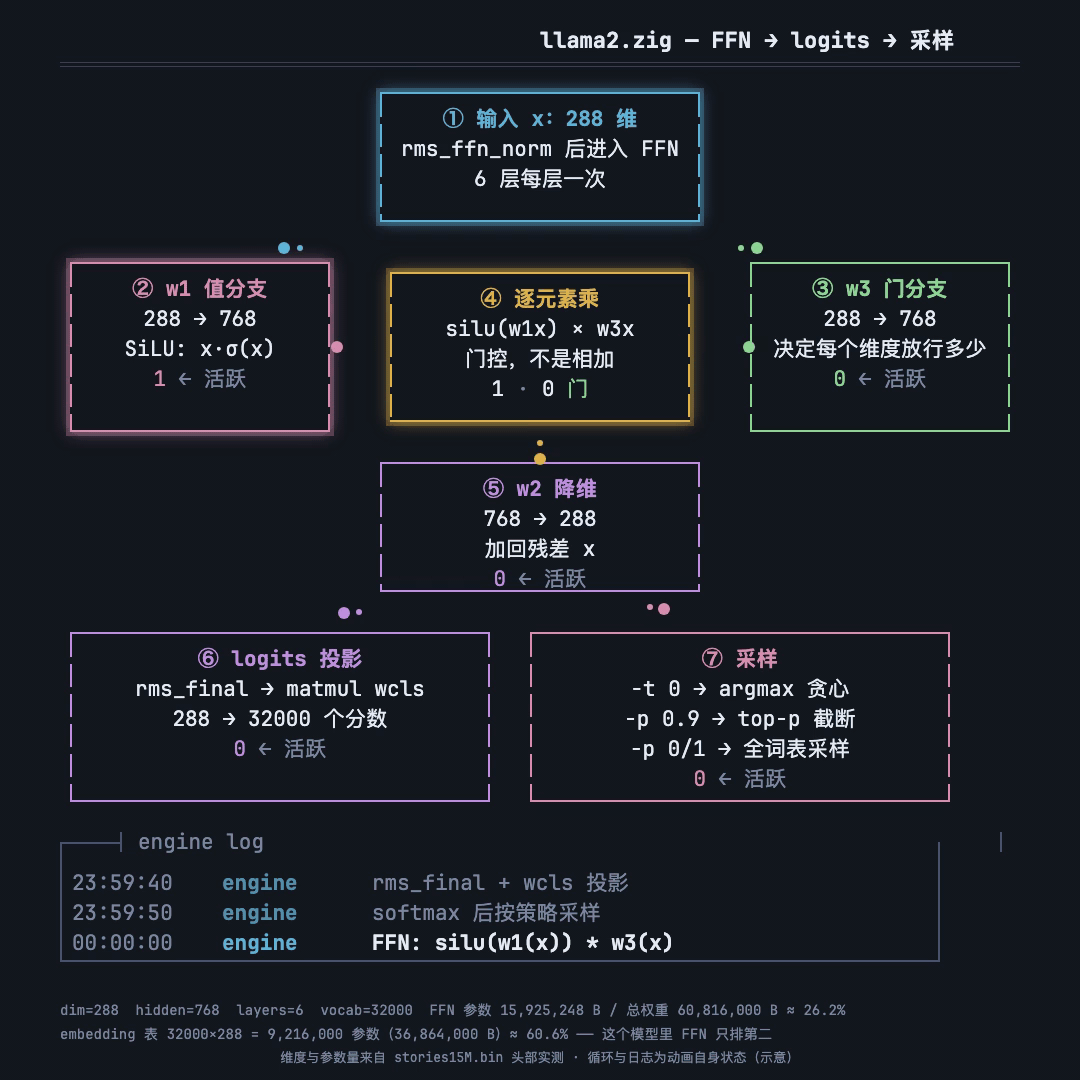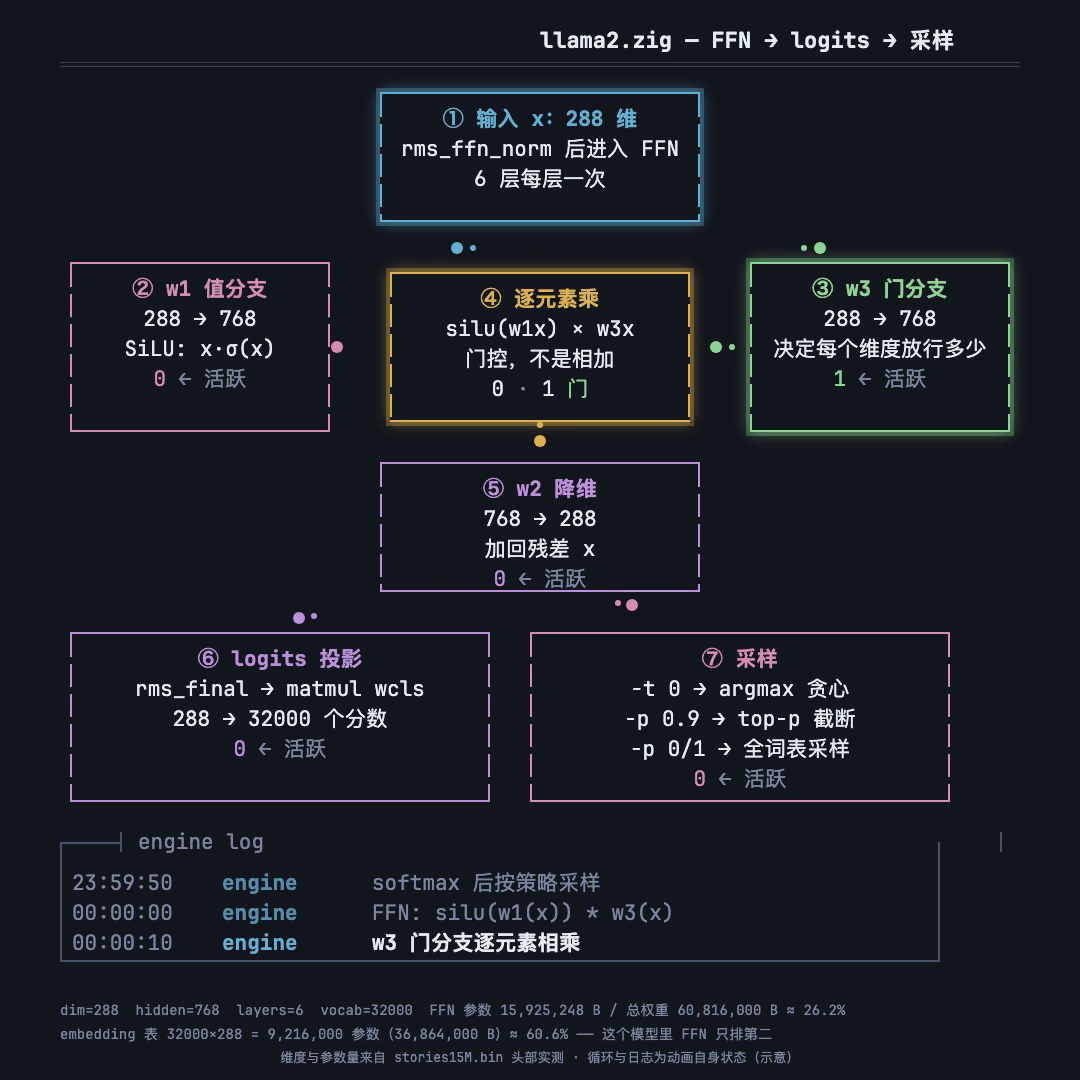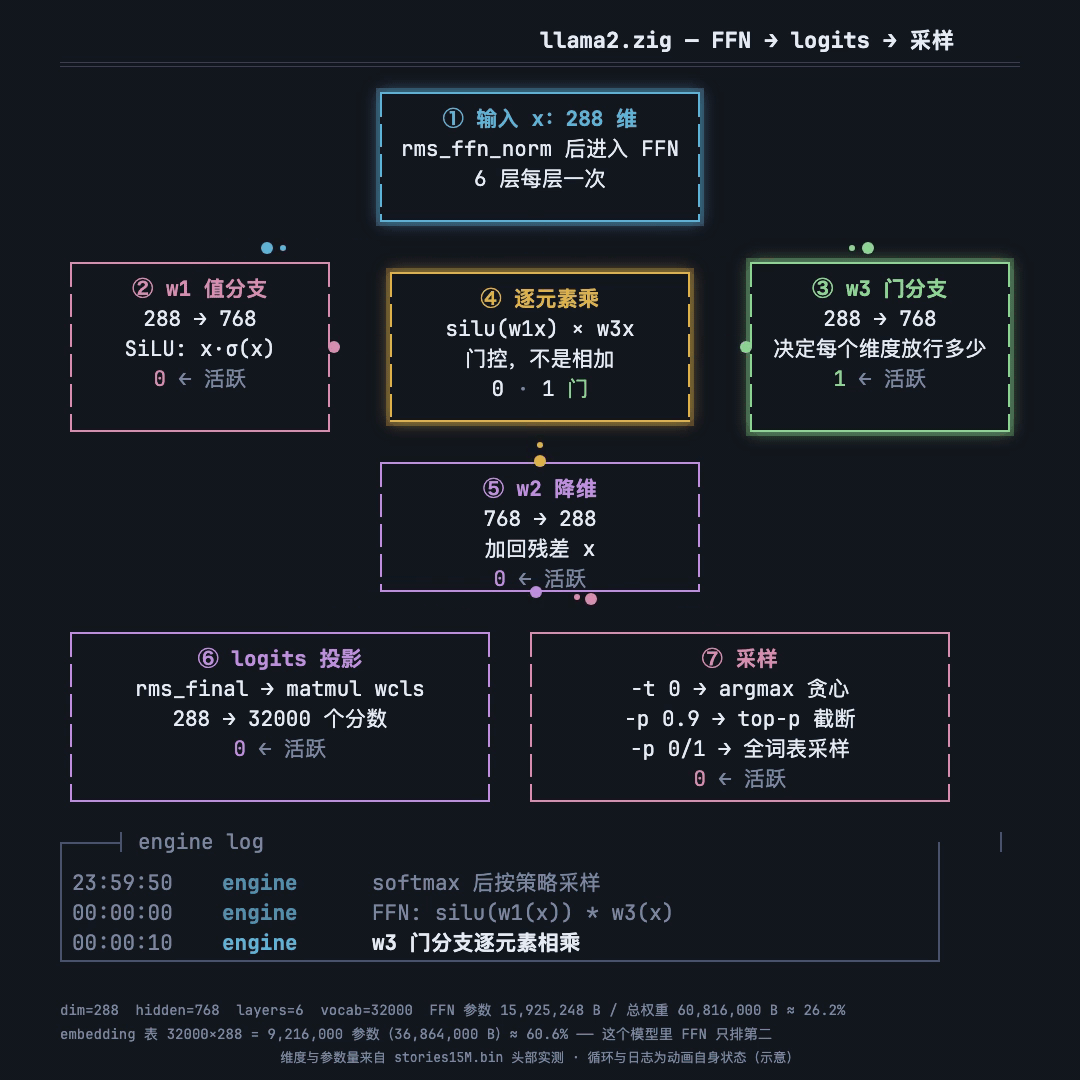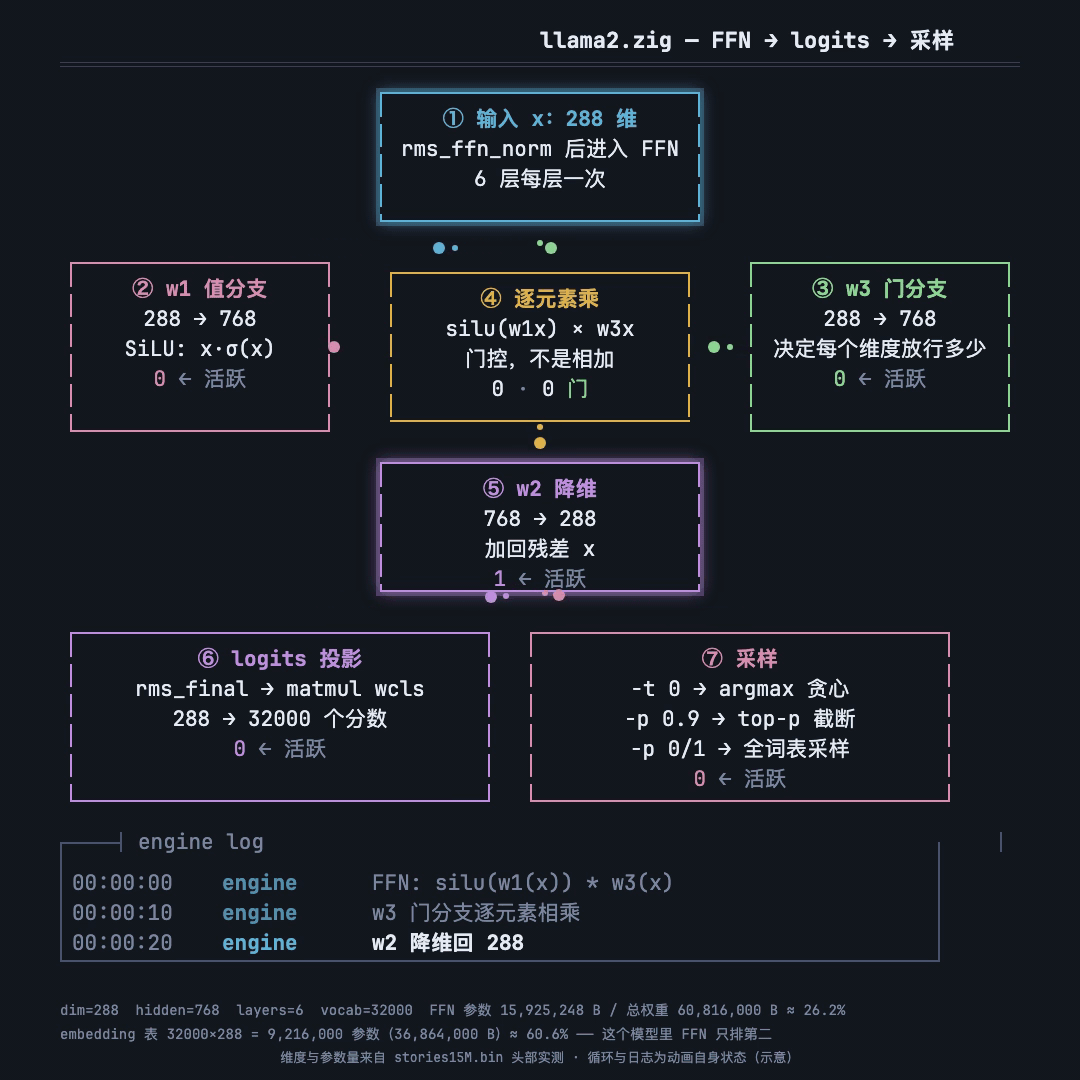
这一章把它拆成三步:
先补上每层加工的另一半——FFN,第二节残差那部分没讲的那一半;
把加工好的坐标 变成 32000 个候选的分数;
最后按分数抽签,抽出来的那个字就是下一个字。
注意力之后还需要加工
经过注意力,每个 token 已经"看过"了前面的 token,知道自己该参考谁。
但它手里的信息 还是以 288 维坐标的形式存在。
FFN(前馈网络)是注意力之后的一轮二次加工:它把 288 维向量先摊开到 768 维,做一轮筛选,再压回 288 维。
为什么要先变宽再变窄?
把 288 个数的坐标想成一张答题卡,格子数固定 288 —— 残差公路要求每个词的纸一样大,不然传不给下一层。
FFN 就是答这张题:先把题目誊到 大三倍的草稿纸上(768 格),一格一格地想。
想什么?单数还是复数、过去时还是将来时、“它"指的是狗还是人。
想明白一条,草稿纸上就落一条。
最后把结论写回 288 格的答题卡,交给下一层。
因为思考的中间步骤,永远比最后的结论多。
768 格草稿纸负责"想得开”,288 格答题 卡负责"传得动"。
草稿纸想铺多大铺多大,答题卡尺寸不能变,这就是 288 → 768 → 288 的全部秘密。
这个模型的 dim = 288,hidden_dim = 768。
每层 FFN 有三个权重矩阵:
w1:288 × 768,把 288 维向量升到 768 维。这是"内容路"。
w3:288 × 768,同样把 288 维升到 768 维。这是"门控路"。
w2:768 × 288,把加工好的 768 维结果降回 288 维。
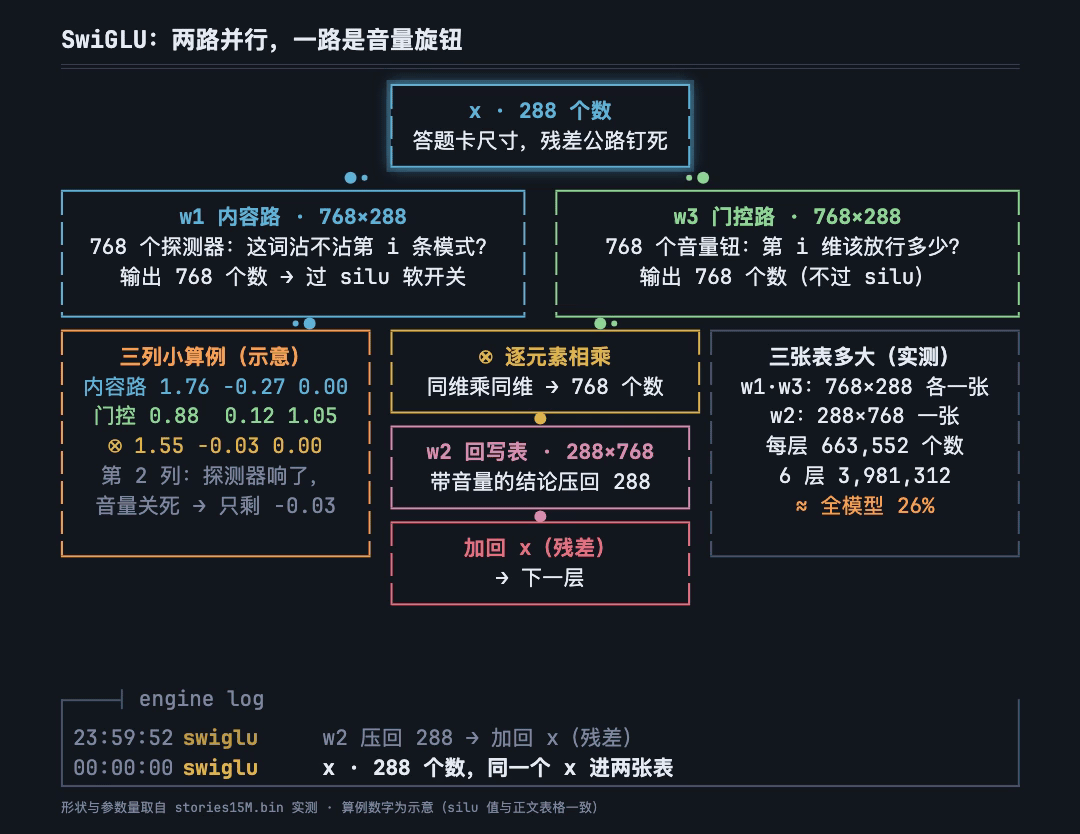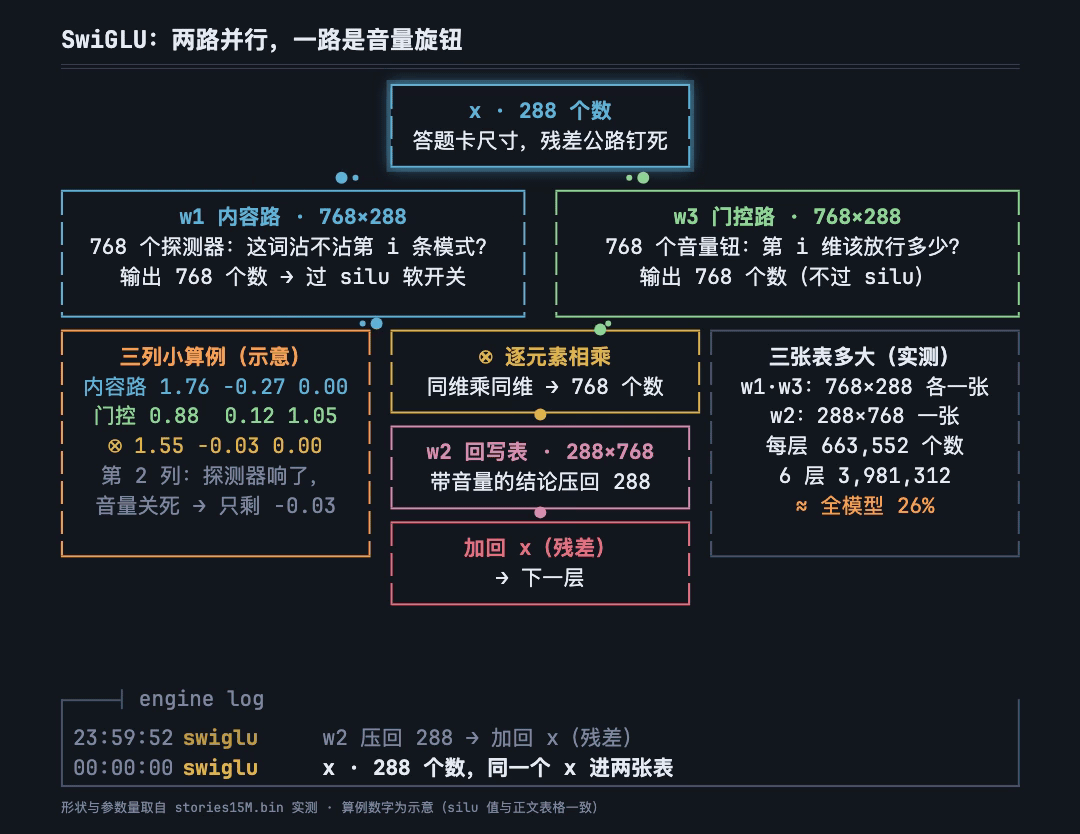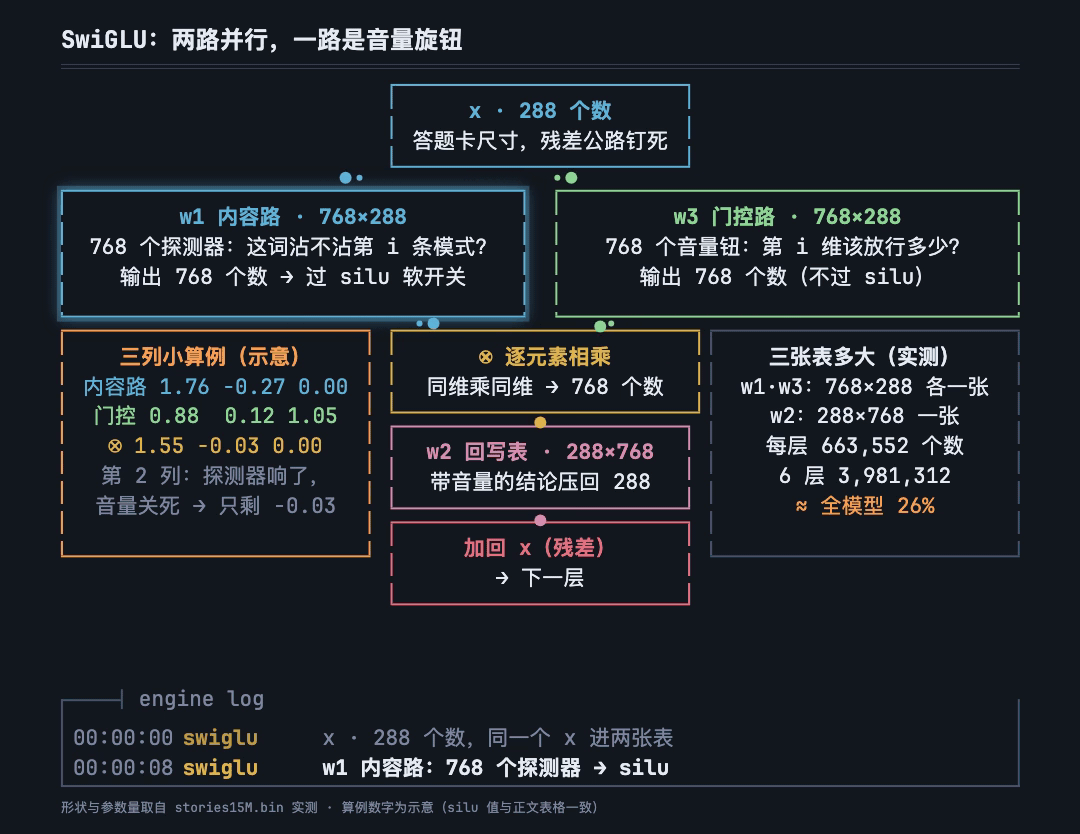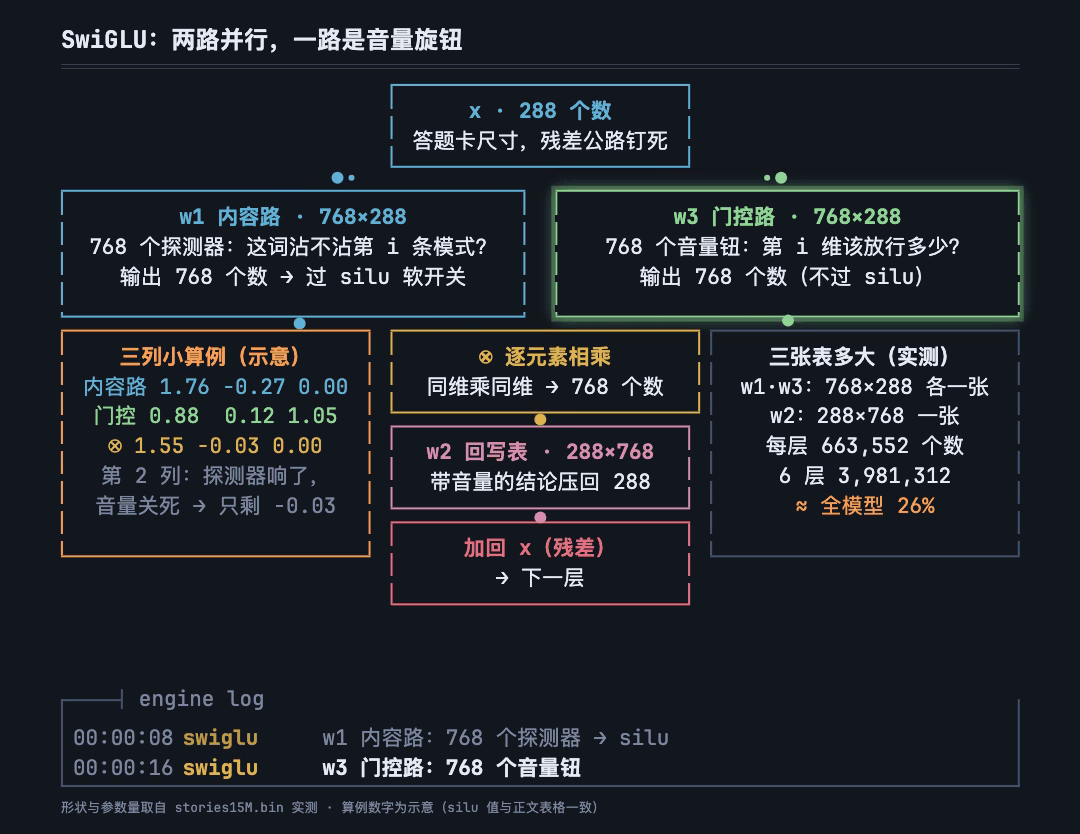
SwiGLU:两路并行,一路是"音量旋钮"
w1 和 w3 都接受同一个 288 维输入,各自输出一个 768 维向量。
它们不是相加,而是逐元素相乘。
w1 的输出是"内容",w3 的输出是"这个内容在每个维度上该放行多少"。
想象 w1 是话筒里的声音信号,w3是音量旋钮:每个维度都有自己独立的旋钮,决定这个频段的声音是放大、减弱还是静音,两者相乘之后才是真正的输出。
这个相乘有个专门的名字:SwiGLU。
它的公式是 silu(w1(o)) × w3(o),其中 × 是 逐元素乘,两个 768 维向量中相同位置的分量相乘,不是矩阵乘法,也不是加法。
SiLU 是"内容路"上给每个数字设的一道自己管自己的门。
规则:把 x 乘上一个 0 到 1 之间的"开度",而开度由 x 自己定——x 越正,门越接近全开,数字几乎原样放行;x 越负, 门越接近关死,只漏出一个很小的负值。
这个开度记作 σ(读作 sigma),全称 logistic sigmoid,公式是 1/(1+e^(−x))。
写成算式就一行:x · σ(x),即"数 × 自己的开度"。
名字唬人,但是作用很好理解:大正数原样过,负数关到几乎为零、但不砍死。
为什么需要SiLU这道门?
假如模型只会"乘表"这一种操作,先乘 w1 这张表、再乘 w2 那张,等价于直接乘一张合并好的大表。
有弯:  x ──乘w1──→ 768个数 ──过SiLU──→ 乘w2 ──→ 288   (768 有存在意义)
   没弯:  x ──乘w1──→ 768个数 ────────乘w2──→ 288
          = x ──乘一张合并好的 (w2·w1) 大表──→ 288          (768 消失)
如果没有 SiLU 这道弯曲,中间那步 768 就纯粹是绕路。
激活函数就是给网络提供"弯曲“的东西。
有了弯曲,才能有二次加工打磨的空间,没有弯曲,前面讲的注意力、残差的工作全是白费。
FFN 门控的代码
// fused version of the above
matmul_fused(2, [_][]f32{ s.hb, s.hb2 }, s.xb, [_][]f32{
    w.w1[l * dim * hidden_dim ..][0 .. dim * hidden_dim],
    w.w3[l * dim * hidden_dim ..][0 .. dim * hidden_dim],
});

// F.silu; silu(x)=x*σ(x),where σ(x) is the logistic sigmoid
for (s.hb) |*v| {
    v.* = v.* * (1.0 / (1.0 + std.math.exp(-v.*)));
}

// elementwise multiply with w3(x)
vector_mul(s.hb, s.hb2);

// final matmul to get the output of FFN
matmul(s.xb2, s.hb, w.w2[...]);
// residual connection
accum(x, s.xb);
- 橙色代码块:
matmul_fused(2, {hb, hb2}, xb, {w1, w3})
拿同一个输入 xb(这个词的 288 个数),同时乘两张表:
输出1:s.hb   = w1 这张表 × xb   → 768 个数(内容路)
输出2:s.hb2  = w3 这张表 × xb   → 768 个数(门控路)
fused(融合)的意思:本来可以写两行 matmul(hb,xb,w1) 和 matmul(hb2,xb,w3),但两张表乘的是同一个 xb。合成一次循环,xb 从内存搬进 CPU 缓存一次就能喂两张表,少跑一趟内存。
数学上和分开算完全一样,纯粹是省时间的写法。
- 绿色代码块:
for (s.hb) |*v| { v.* = v.* * (1.0 / (1.0 + exp(-v.*))); }
这就是示意图里”输出 768 个数 → 过 silu 软开关“那一格。
所以这个循环 = 把 768 个数各自过一遍“自己管自己的门”:大的正数几乎原样留下,负数被压成一个小负值。
只有 hb(内容路)过这个循环,hb2(门控路)不过。
- 蓝色代码块:
vector_mul(s.hb, s.hb2)
把两个 768 维向量同位相乘,结果写回 hb:
hb[i] = hb[i] × hb2[i] (i = 0…767,共 768 次普通乘法)
就是 SwiGLU 图里那个橙色 ⊗:内容 × 音量,逐维独立。
注意这是 768 次标量乘法,不是矩阵乘。
- 橙色代码块:
matmul(s.xb2, s.hb, w.w2[...])
把带完音量的 768 个数乘 w2(288×768)压回 288,存进 xb2。
然后accum(x, xb2) 加回残差流。
从 288 维到 32000 个分数
6 层注意力 + FFN 循环跑完之后,模型手里有一个 288 维向量。
它要把这个向量变成 **32000 个分数 **—— 词表里每个候选 token 各一个。
这些分数叫 logits:还没变成概率的原始打分,可以是任意正数或负数,大小不一。
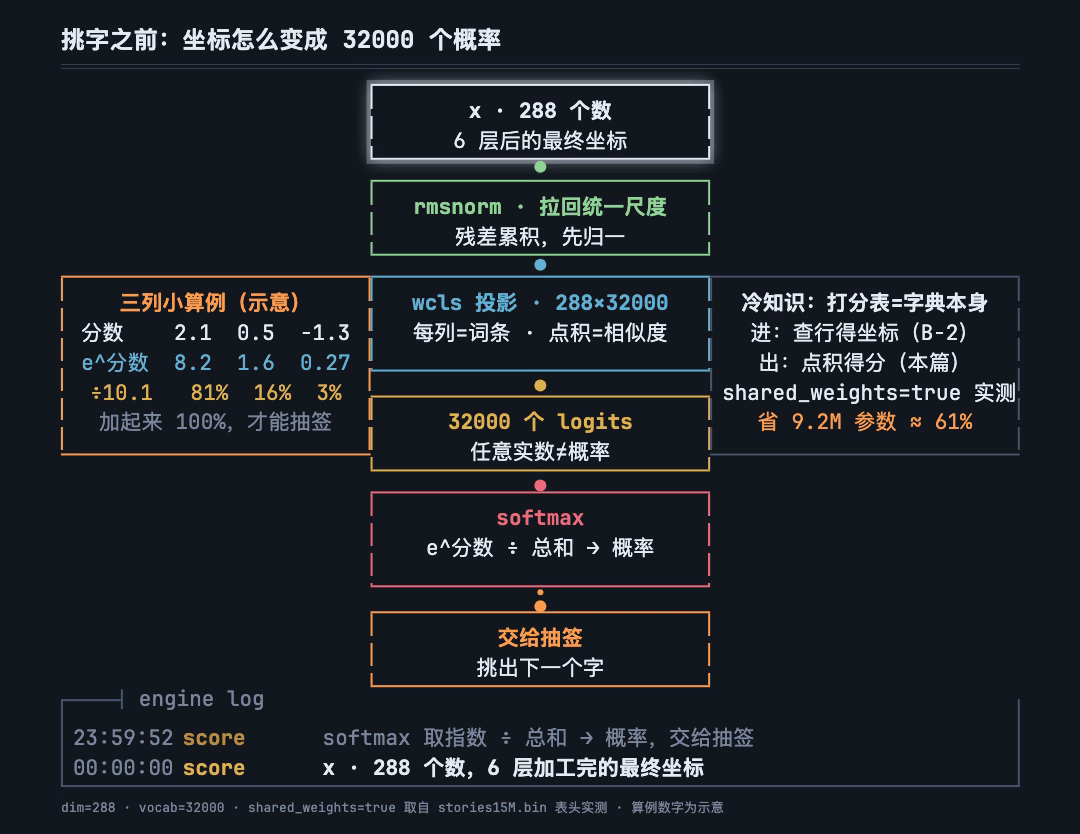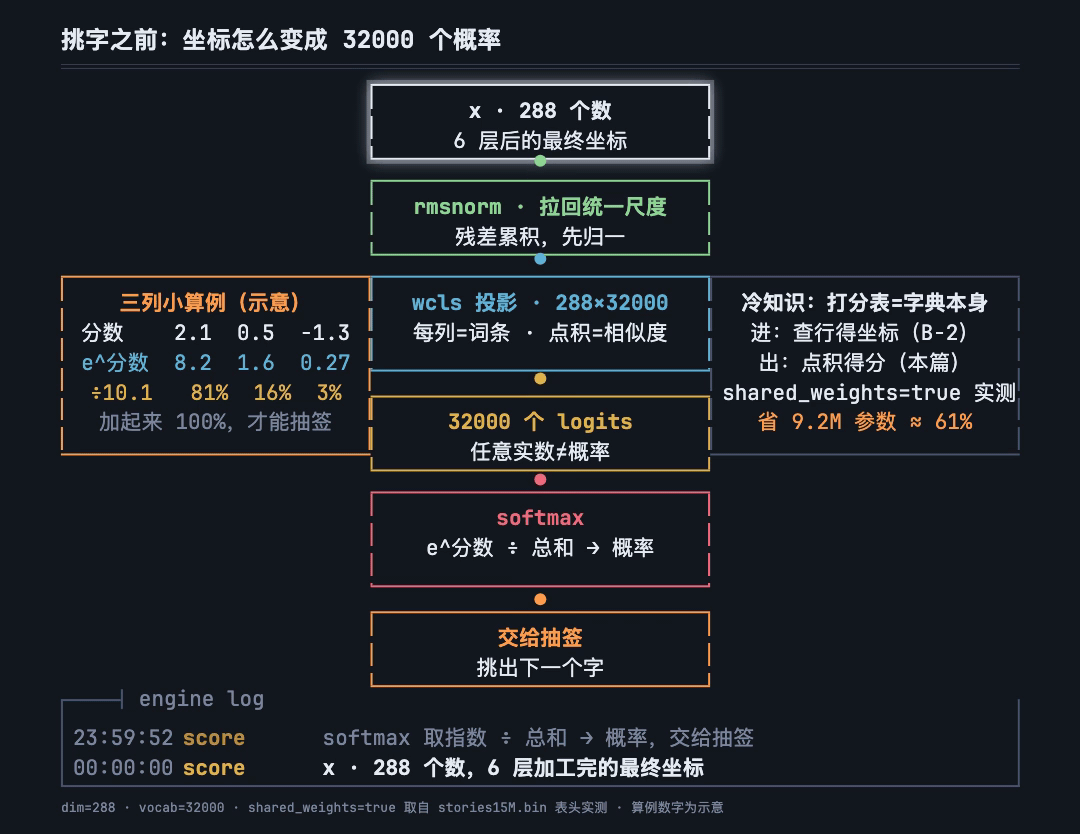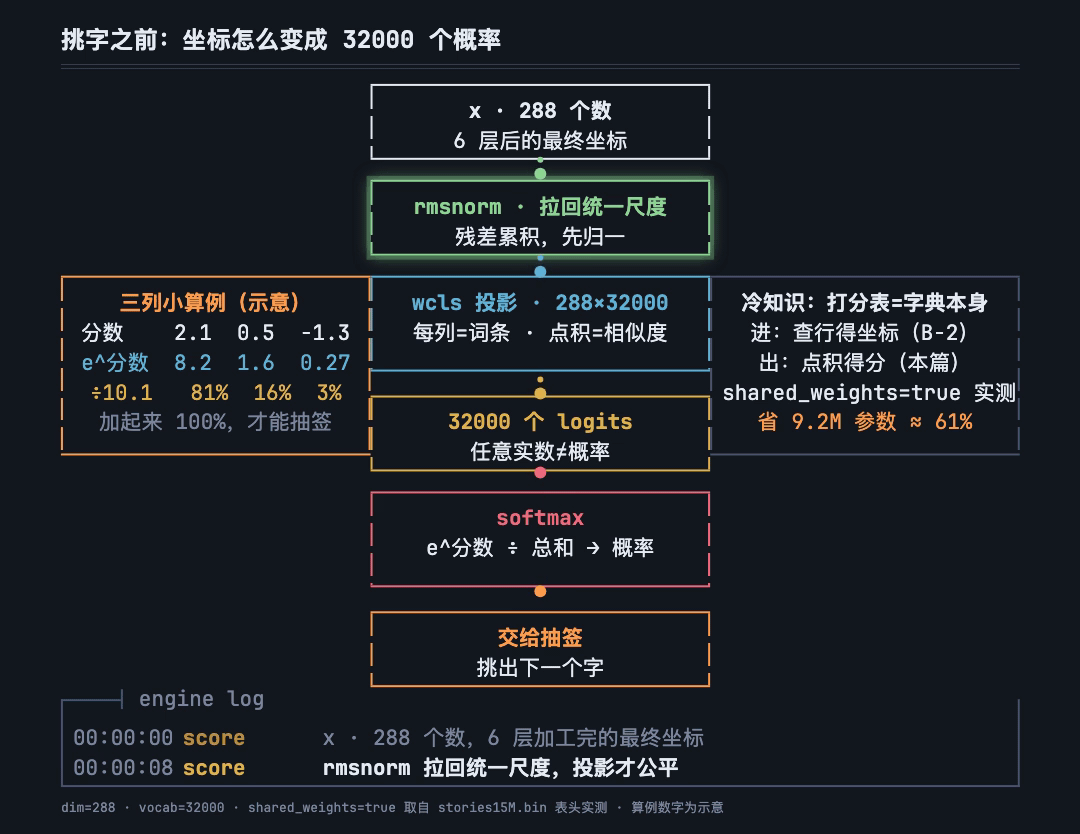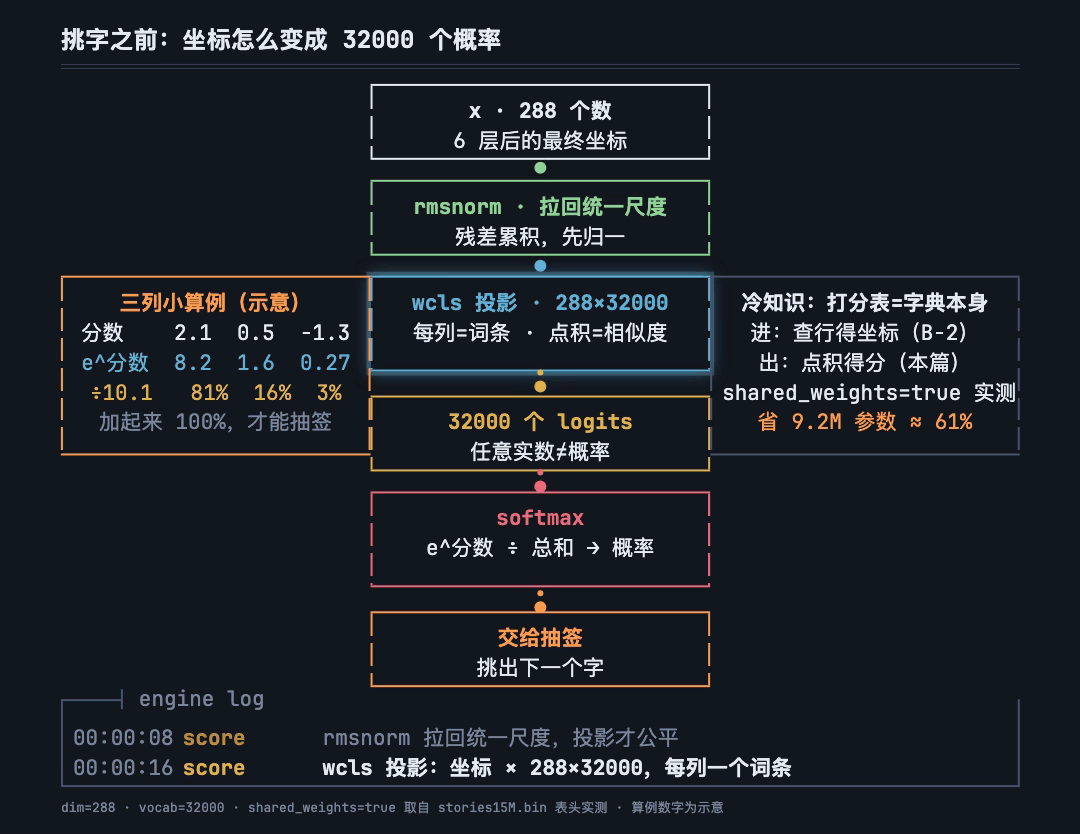
这一步用的矩阵叫 wcls,大小是 288 × 32000。
它把 288 维向量投影到 32000 维 —— 每个维度对应词表里的一个token,投影结果就是那个 token 的分数。
wcls 和 embedding 表是同一块内存
这个知识在第二章最后一小节做过解释了。
打分的完整过程如下:
从 288 维向量到 32000 个分数,中间还有一步 rmsnorm(把数值拉回统一尺度),然后才做 288 × 32000 的投影。
投影完成后得到 32000 个 logits。这些数字还不是概率——它们可以是任何实数。要变成概率分布(所有值加起来等于 1),需要过一遍 softmax:把每个分数取指数(变成正数),再除以所有指数的总和(归一化到 0–1)。
temperature 和 top-p:怎么把分数变成一个词
32000 个 token 各有一个概率了。
采样策略决定"选谁”。
temperature:手松还是手紧
温度(temperature)在 softmax 之前缩放 logits。
效果类比抽签时"手松还是手紧":
t = 0:永远选分数最高的那个(贪心)。每次运行输出完全相同。
t = 1.0:按原始概率抽签。高分 token 被抽中的概率大,但低分 token 也有机会。
t 更高:分布更平,抽签更随机,输出更"跳脱"。
if (pos < prompt_len) {
    next = prompt.?[pos];
} else {
    if (temperature == 0.0) {
        next = argmax(state.logits);
    } else {
        if (temperature != 1.0) {
            **for (state.logits) |*val| val.* /= temperature**;
        }
        softmax(state.logits);
        next = if (top_p == 0.0 or top_p == 1.0)
            sample(state.logits)
        else
            sample_top_p(state.logits, top_p, state.logits_indexed);
    }
}
temperature原理:
温度除以 logits 后再过 softmax过程中,
t → 0 时,最大 logit 的 exp 项压倒其他项, 分布变成"只有一个候选概率是 100%,其他全是 0"——这就是贪心。
t → ∞ 时,所有 logits 除以无穷后都趋近 0,exp(0) = 1,分布变成均匀,每个 token 相同概率。
我们对temperature做一下测试:
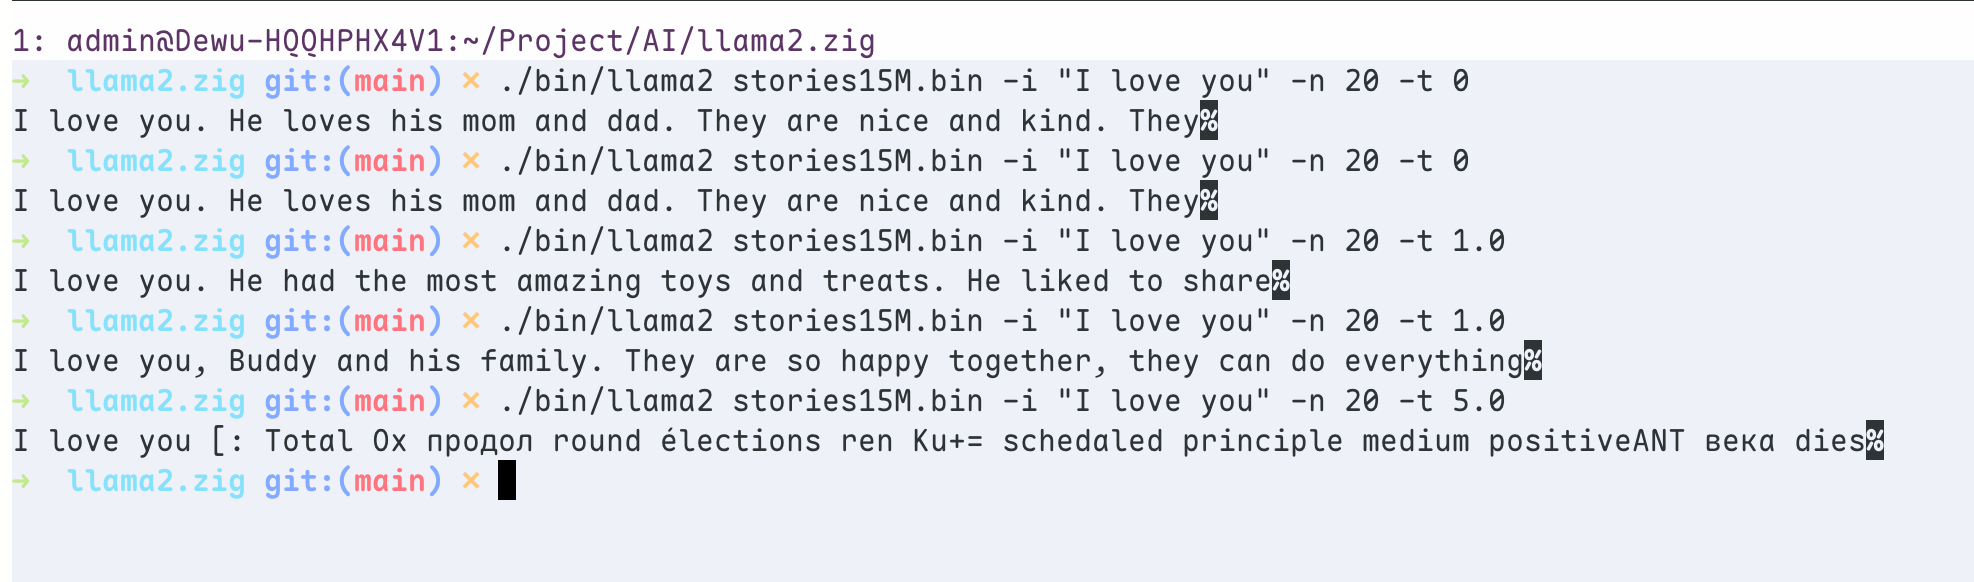
从测试结果可见:
当t=0时,运行2词结果都是一样,因为用argmax的结果;
当t=1时,概率给了“had”这个词机会,2次运行出现了不一样的结果。
当t=5时,输出的结果非常“跳脱”,缺乏可读性。
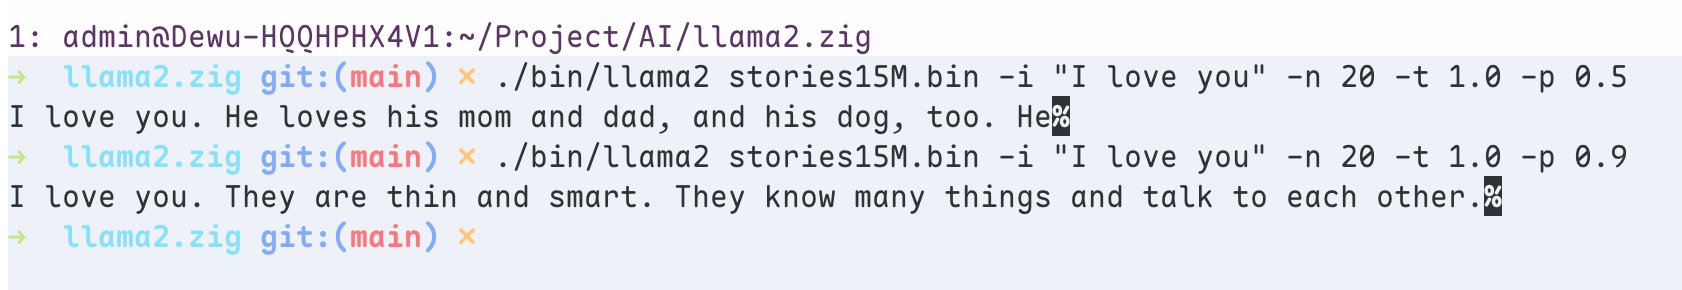
top-p 是什么(以及这个实现的实际行为)
top-p(也叫 nucleus sampling)的原始想法:把 token 按概率从高到低排,取前几个 直到它们的概率加起来超过 p(比如 0.9),然后只从这几个里抽。
p = 0.9 意味着"只从概率最大的那 90% 里选"。
分布很陡时(一个 token 占 95%),top-p 可能只留 1 个;
分布很平时(100 个 token 各 1%),top-p 可能留 90 个。
所以 -p 只在模型犹豫(分布平)时才起作用,模型自信(分布陡)时裁了也白裁。
fn sample(x: []f32) usize {
    assert(x.len > 0);
    const random = prng.random();
    const r = random.float(f32);

    var cdf: f32 = 0.0;
    for (x, 0..) |val, i| {
        cdf += val;
        if (r < cdf) {
            return i;
        }
    }
    return x.len - 1;
}
把它想象成一条从 0 到 1 的长走廊,每个 token 占据走廊上的一段——概率越大,地盘越宽。
随机数 r 就是你在走廊上扔球的位置。
球落在谁的地盘里,谁就被选中。
概率大的 token 地盘宽,被砸中的概率自然大。
全篇回顾
到此为止,四章讲完了,我我们回顾一遍你输入"I love you"之后模型内部发生了什么:
1 · 文字变成编号**:**你的文字经过词表和 BPE 切分,变成 [29902, 5360, 366] 这样的编号序列。
词表是一本 32000 条的固定手册,模型只认编号不认字。
**2 · 编号变成坐标:**每个编号去 embedding 表里查一串坐标(288 个数)。
意思相近的词坐标也靠近。
这些坐标经过 rmsnorm 归一化、旋转让它们携带位置信息。
**3 · 坐标互相交流:**每个 token 通过注意力"看"前面的 token,决定该重点参考谁。
Q/K/V 三张对照表分工协作,softmax 把注意力分数变成权重,KV cache 把前面 token 的 标签和内容存下来复用。6 层循环让信息一层层加深。
**4 · 坐标变成分数,分数变成字:**注意力之后,FFN 做一轮"摊开→筛选→压回"的加工。
SwiGLU 门控决定哪些信息放行。
最后 288 维向量变成 32000 个分数(logits),过 softmax 变成概率,按温度和 top-p 的规则抽签挑出一个 token。
这个系列没讲什么?
这个模型只会"续写",不会"回答问题"。
ChatGPT 能聊天,中间还隔着一层指令微调,那不在这条线上。
多模态、工具调用、智能体,都是装在这根骨架外面的东西。
怎么算得更快(SIMD、缓存优化、并行)是实现工程,也不继续展开。
一生接一生
一个字的一生,终点不是被打印出来。
它被接到句尾,成为下一个字回头看的所有前辈之一,然后下一个字再出生一遍。
你现在知道每一次出生要付什么账了:查表、旋转、六层回望、三张 FFN 表、32000 个分数、一次抽签。
这就是"生成"。
它不是数据库,也不是人脑,只是一条每个字都要重跑一遍的流水线。
一千五百万参数是这么跑的,四千零五十亿也是,区别只是数字更大。
下次 AI 答得轻描淡写,你就知道那背后是几万次回望。